Assistente IA privato per PMI su GB10: mesures
Su una GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), uno stack software completo (l'interfaccia Open WebUI, il modello gpt-oss 120B e il modello di ricerca bge-m3) si avvia in 66 secondi e occupa 68 GB. Indicizza 5 000 pagine in 6 minuti, trova il documento giusto nell'86 % dei casi su 500 pagine (78 % su 5 000) e risponde in 10 secondi a una persona. Durante 200 risposte, nessun container ha inviato pacchetti verso l'esterno. Ogni risposta costa 0,15 Wh lato GPU.
Una PMI che vuole interrogare i propri contratti e le proprie procedure con un'IA si pone presto una domanda: dove vanno a finire i miei documenti? Un assistente privato tiene tutto su una macchina dell'ufficio. Si basa sulla RAG (generazione aumentata dal recupero): il sistema cerca prima i passaggi utili nei tuoi file, poi un modello redige la risposta. Abbiamo misurato uno stack completo su un AI TOP ATOM fornito gratuitamente da GIGABYTE, con i documenti di un'azienda fittizia.
#Cosa contiene lo stack: tre software, 68 GB
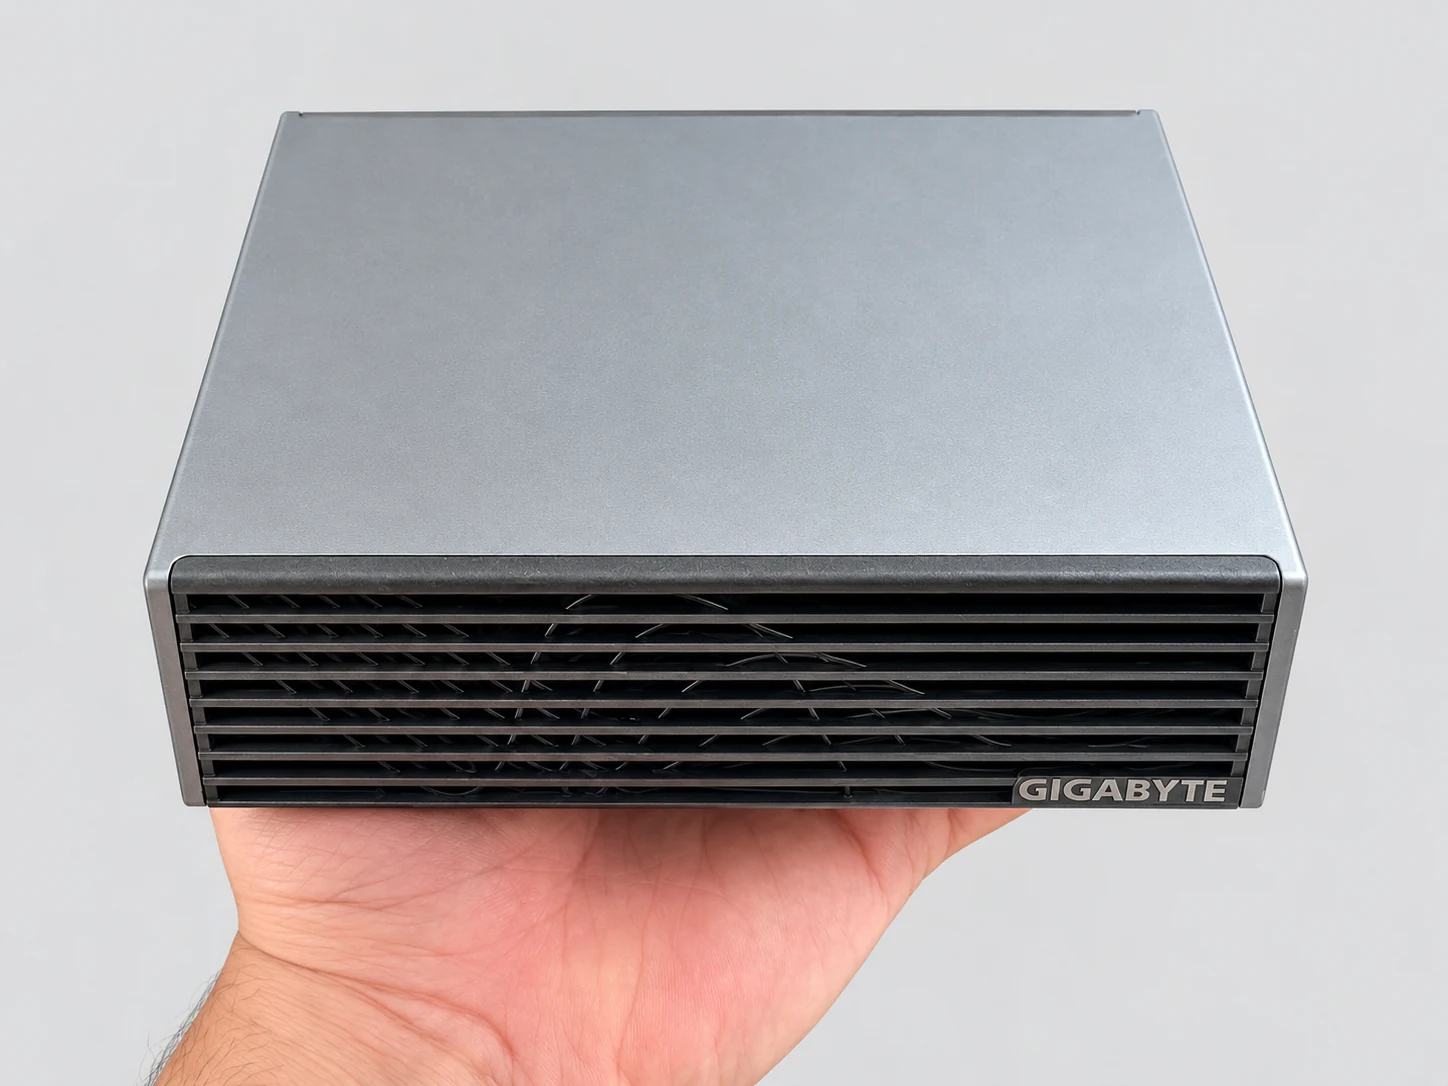
Un assistente privato si compone di tre elementi, che abbiamo installato in container Docker su una AI TOP ATOM (codice ATAGB10-9000, DGX OS 7.5.0). I modelli girano con llama.cpp, build 11430.
- Open WebUI 0.11.4
- L'interfaccia web: account, importazione dei file, basi di conoscenza e conversazione. È sempre questo componente a suddividere i documenti in estratti, 1 000 caratteri con 100 di sovrapposizione per impostazione predefinita, e a tenere i 5 estratti più vicini a ogni domanda.
- gpt-oss 120B (MXFP4)
- Il modello che redige la risposta, servito da llama-server (il server incluso in llama.cpp). MXFP4 è il suo formato originale, già compresso. È configurato per 10 richieste in parallelo. È un modello MoE (mixture of experts): a ogni token usa solo 5,1 dei suoi 117 miliardi di parametri.
- bge-m3 (Q8_0)
- Il modello di embedding, usato qui in versione Q8_0 (compressione a 8 bit). Trasforma ogni estratto in una sequenza di numeri che ne rappresenta il significato, il che permette di confrontare una domanda con gli estratti. È multilingue, quindi adatto al francese.
L'avvio completo, a partire da una cache del disco svuotata, ha richiesto 66 secondi fino a un'interfaccia pronta. Lo stack occupa 68,0 GB di memoria: il processo gpt-oss 120B ne occupa 63,6 GB lato GPU e bge-m3 0,8 GB; il resto proviene da Open WebUI e dal sistema.
Dopo l'avvio, sulla macchina restano disponibili 48,6 GB. Le memorie di questa guida sono in GB, come le mostra Linux: 1 GB = 1 024 MB. La nostra prima guida della serie descrive in dettaglio la velocità di gpt-oss 120B: 58 token al secondo.
#L'azienda fittizia e le 100 domande
Approfitta della nostra esperienza e di un percorso guidato per costruire il tuo RAG locale e lavorare con i tuoi documenti.
- Spazio online a vita
- PDF + file
- Rimborso in 30 g
Lustrelle è una PMI fittizia che abbiamo inventato: un laboratorio, un magazzino, un servizio post-vendita e degli uffici. I suoi 60 documenti sono file di testo in formato Markdown (un testo semplice con qualche simbolo per i titoli e gli elenchi). Trattano di risorse umane, sicurezza del laboratorio, backup, note spese, resi dei clienti o piano di formazione. Contengono cifre, nomi e condizioni precisi, affinché ogni risposta sia verificabile.
Per raggiungere volumi realistici, abbiamo aggiunto delle schede pubbliche di Service-Public, come previsto dal nostro protocollo. Ne risultano tre basi di dimensioni crescenti. I dettagli metodologici di questa guida sono fissati da un'integrazione al nostro protocollo, datata 7 ottobre 2026, prima della prima risposta dell'assistente. Il protocollo è stato congelato prima della prima misurazione; il metodo, l'elenco datato delle integrazioni e i dati delle nostre tabelle sono pubblicati sulla nostra pagina dedicata al metodo.
| Base | File | Contenuto |
|---|---|---|
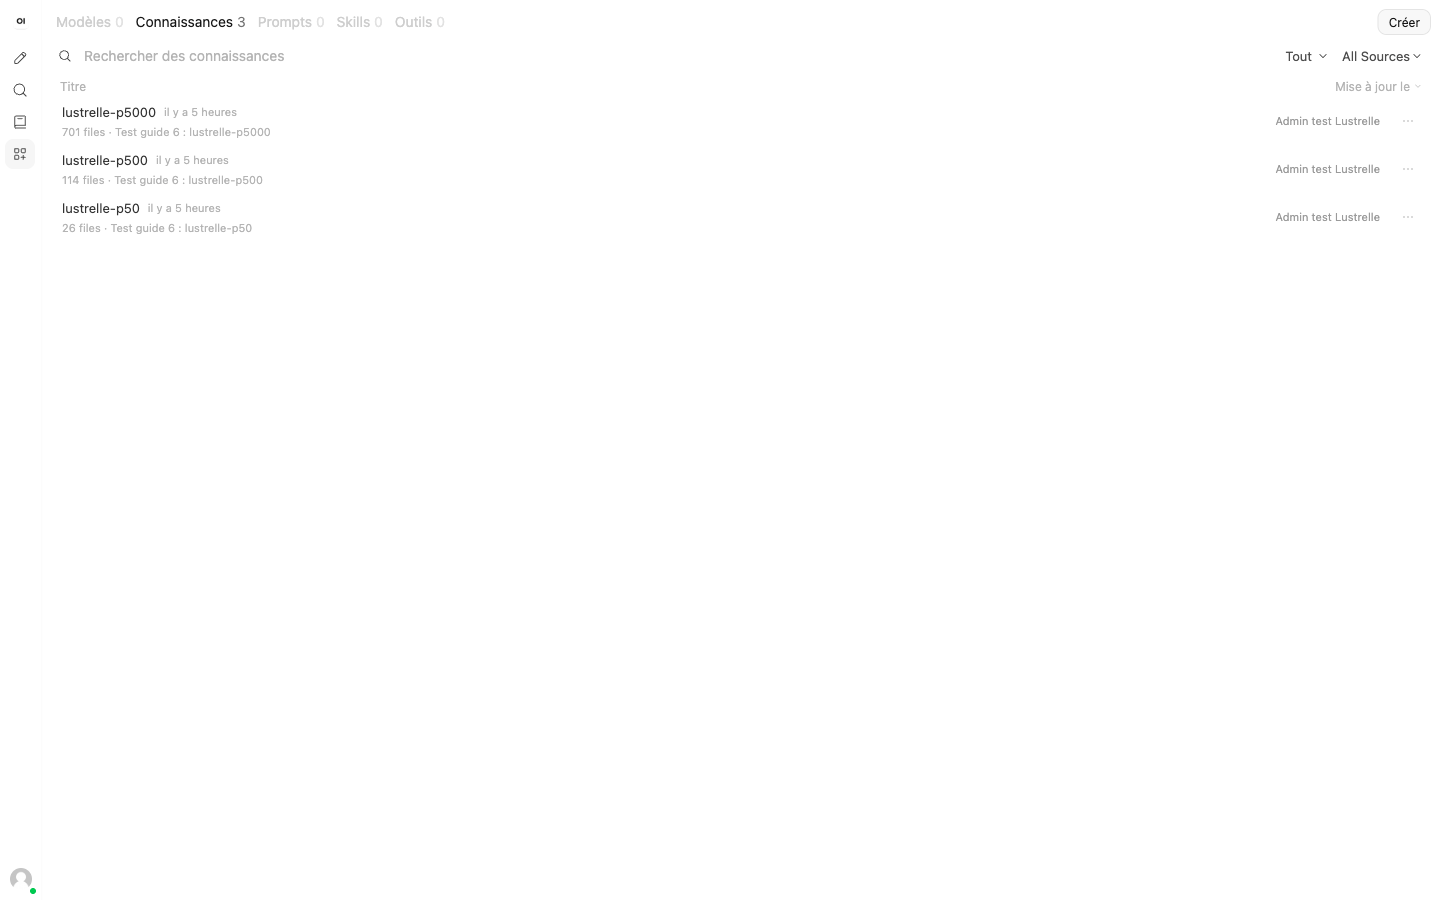
| 50 pagine | 26 | 26 dei 60 documenti di Lustrelle |
| 500 pagine | 114 | i 60 documenti di Lustrelle e 54 schede Service-Public |
| 5 000 pagine | 701 | i 60 documenti di Lustrelle e 641 schede Service-Public |
Le 100 domande sono poste così come sono, senza riformulazioni. 80 di esse hanno la risposta nei documenti: 50 domande fattuali, 10 di procedura, 10 su cifre e 10 di sintesi. 20 non hanno alcuna risposta nei documenti: servono a verificare che l'assistente lo ammetta invece di inventare.
- Fait
- Quanti addetti di primo intervento antincendio abbiamo? Risposta attesa: dieci, designati tra i dipendenti.
- Chiffre
- Quanto costa IVA inclusa la sospensione Brindille da 60 cm in rovere affumicato? Risposta attesa: 360 € IVA inclusa (348 € in rovere naturale, più 12 € per la finitura affumicata).
- Senza risposta nei documenti
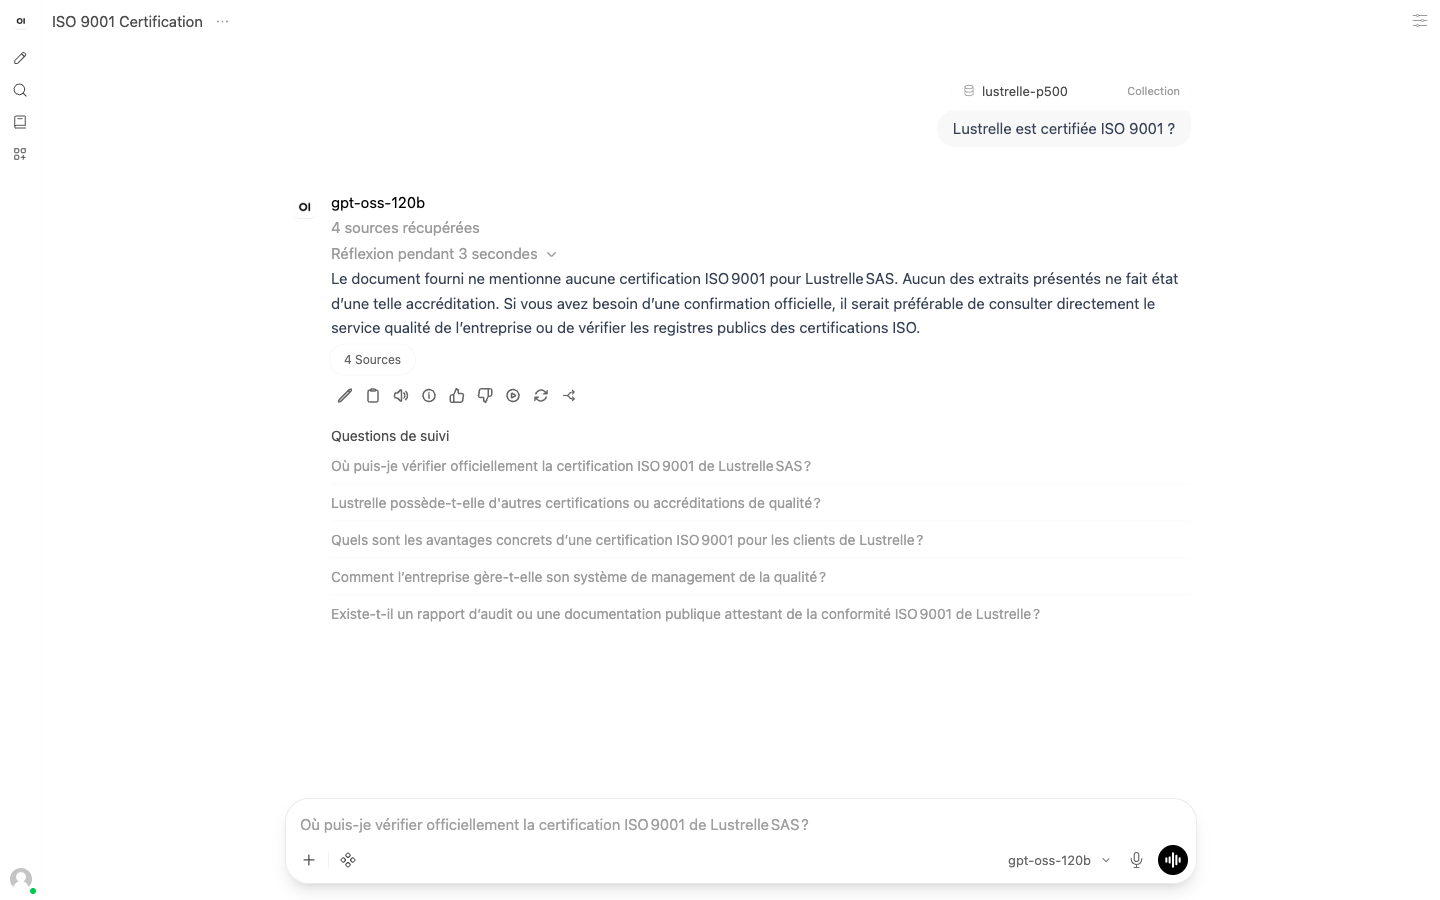
- Lustrelle è certificata ISO 9001? Risposta attesa: l'assistente dice che i documenti non lo menzionano.
#Configurare lo stack: i comandi
Lo stack si compone di tre container e due reti Docker. La prima rete è «interna»: Docker non vi concede alcun accesso all'esterno. I due server dei modelli sono collegati solo a questa rete. Open WebUI è collegato a questa rete interna, per comunicare con i modelli, e a una seconda rete, attraverso la quale apri l'interfaccia nel tuo browser.
I comandi qui sotto sono quelli dei nostri test del 7 e 8 ottobre 2026, con percorsi semplificati. llama.cpp (build 11430) è compilato sulla macchina per il chip GB10; il comando di compilazione si trova nel tutorial 70B di questa serie.
L'opzione -np 10 apre 10 slot: dieci richieste possono procedere contemporaneamente (la guida llama.cpp di NVIDIA ne prevede 4 per impostazione predefinita). L'opzione -c 131072 fissa il contesto totale, che gli slot si dividono. RAG_TOP_K a 5 richiede cinque estratti per domanda. Le variabili OFFLINE_MODE, ANONYMIZED_TELEMETRY, DO_NOT_TRACK e SCARF_NO_ANALYTICS disattivano i controlli degli aggiornamenti, i download da Internet e la telemetria di Open WebUI. La suddivisione resta quella predefinita di Open WebUI, regolabile dalla sua interfaccia.
- 01Apri Open WebUIVai su http://127.0.0.1:3100 e crea l'account amministratore. Scegli gpt-oss-120b come modello.
- 02Crea una base di conoscenzaApri la sezione Conoscenza, crea una base e aggiungi i tuoi file. Open WebUI legge ogni file, lo suddivide in blocchi e ne calcola gli embedding.
- 03Interroga la baseIn una conversazione, digita il simbolo cancelletto seguito dal nome della base, poi fai la tua domanda. La risposta compare con le sue fonti.
Le nostre misure passano per l'API di Open WebUI, il che permette di rieseguirle tramite script. Ecco le stesse chiamate del nostro script di misura (scritto in Python), trascritte con curl e jq.
#Indicizzare 50, 500 e 5 000 pagine
Indicizzare significa leggere ogni file, suddividerlo in estratti, calcolare gli embedding con bge-m3 e salvare il tutto nella base. Il nostro script invia i file 4 alla volta e cronometra fino all'ultimo file elaborato. Nessun file è fallito.
| Base | File | Durata | Errori |
|---|---|---|---|
| 50 pagine | 26 | 9,2 s | 0 |
| 500 pagine | 114 | 46,8 s | 0 |
| 5 000 pagine | 701 | 365,9 s (6,1 min) | 0 |
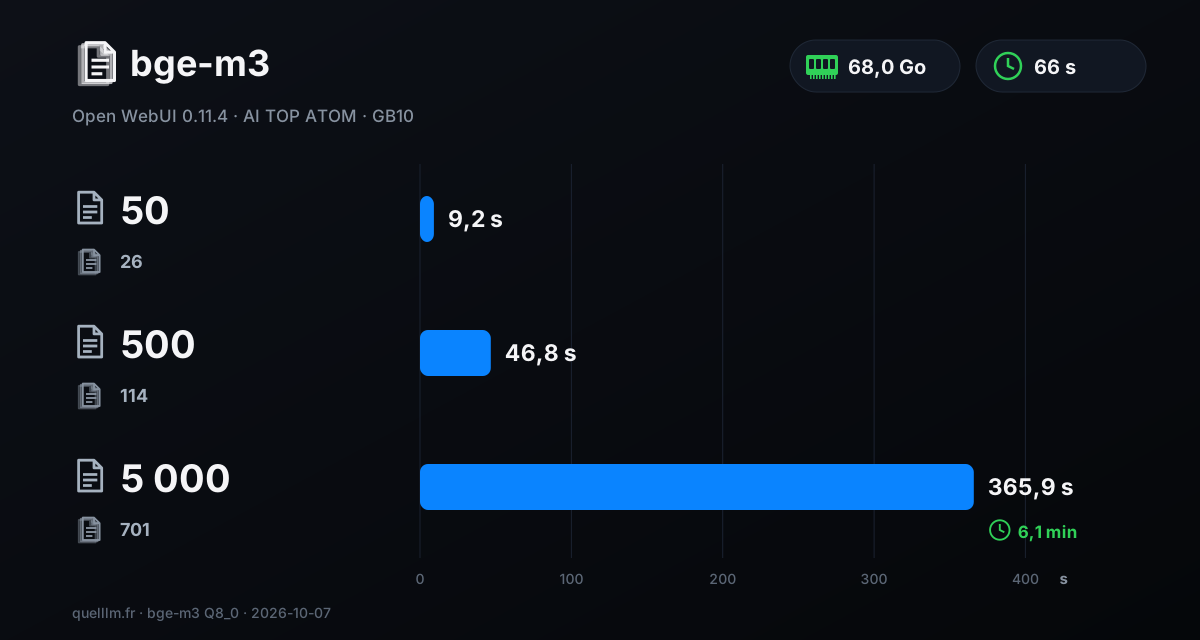
5 000 pagine sono pronte in poco più di 6 minuti, ovvero circa 1,9 file al secondo. Reindicizzare un archivio di 5 000 pagine richiede quindi meno di 7 minuti. Durante questa indicizzazione, la GPU ha consumato 5,4 Wh.
#Il documento giusto viene trovato?
Prima della qualità delle risposte, bisogna sapere se l'assistente va a cercare nel posto giusto. Il nostro indicatore automatico, «documento giusto trovato», conta le domande per cui almeno uno dei documenti attesi figura tra le fonti restituite da Open WebUI. Riguarda le 80 domande che hanno una risposta nei documenti. Lo calcola uno script; non è un voto di qualità e non dice se la risposta è corretta.
| Base | Documento giusto trovato | Risposte ricevute senza errori | Durata mediana di una risposta |
|---|---|---|---|
| 500 pagine | 86 % (69 domande su 80) | 100 su 100 | circa 40 s |
| 5 000 pagine | 78 % (62 domande su 80) | 100 su 100 | circa 42 s |
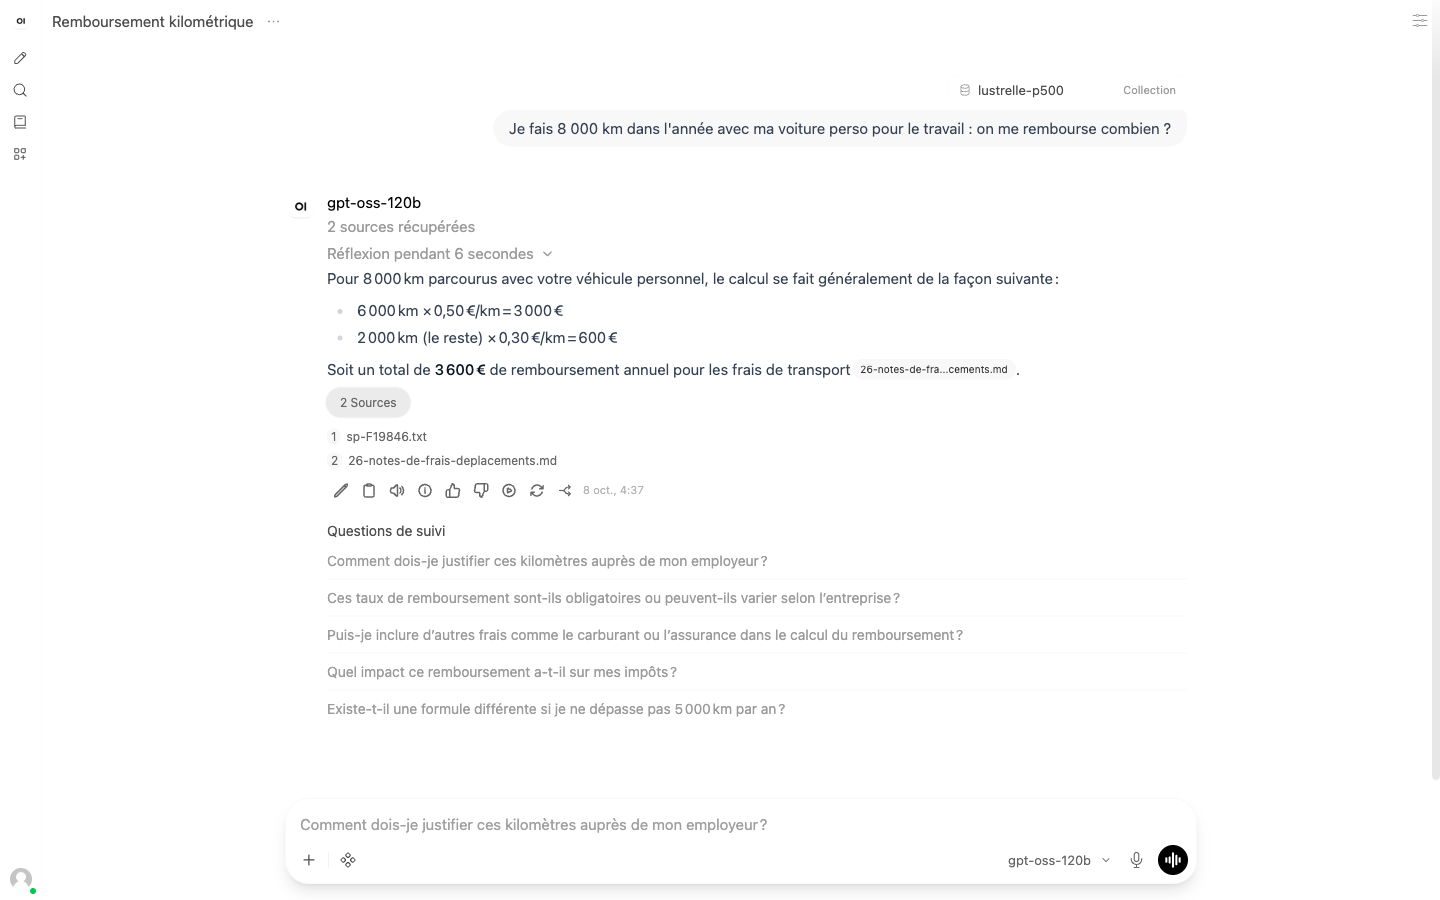
Con circa sei volte più file (701 contro 114), il documento giusto viene comunque trovato nel 78 % dei casi. Le 100 risposte di ciascuna base sono arrivate senza errori tecnici né risposte vuote, ognuna con l'elenco delle sue fonti. Questo elenco permette di verificare: basta un clic sul pulsante delle fonti per vedere i file utilizzati.
#Quante persone contemporaneamente?
Abbiamo simulato 1, 5 e poi 10 utenti che interrogano lo stack contemporaneamente. Si trovano su un Mac collegato all'ATOM tramite un tunnel SSH che passa per Tailscale, una rete privata. Ogni utente fa 6 domande di seguito, senza pause tra una domanda e l'altra, e le risposte arrivano in streaming. Rileviamo il tempo alla prima parola e il tempo della risposta completa, in mediana. Ogni serie conta 6, 30 o 60 richieste; nessuna è fallita.
| Utenti | Base | Prima parola | Risposta completa |
|---|---|---|---|
| 1 | 500 pagine | 9,0 s | 9,6 s |
| 1 | 5 000 pagine | 9,9 s | 10,2 s |
| 5 | 500 pagine | 33,1 s | 38,4 s |
| 5 | 5 000 pagine | 39,3 s | 44,7 s |
| 10 | 500 pagine | 52,4 s | 63,5 s |
| 10 | 5 000 pagine | 50,2 s | 64,8 s |
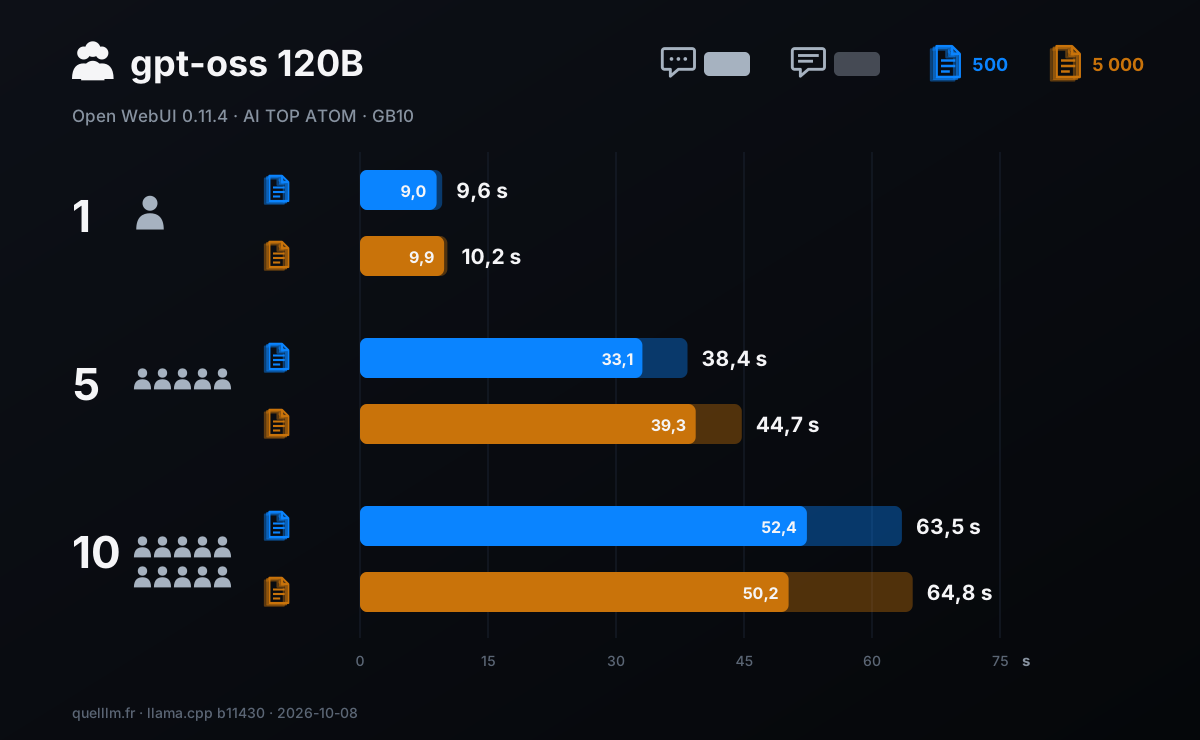
Per una sola persona, la risposta completa arriva in 9,6 s su 500 pagine e in 10,2 s su 5 000 pagine. Quando 5 persone fanno la loro domanda contemporaneamente, la mediana sale a 38 s e 45 s. Con 10 persone, è di circa un minuto: 63,5 s e 64,8 s. La dimensione della base cambia poco questi tempi: da 500 a 5 000 pagine, la differenza va da 0,6 a 6,4 secondi.
La prima parola arriva dopo la fase di ragionamento di gpt-oss 120B: Open WebUI mostra allora «Ragionamento per 6 secondi» o una durata simile. Questa fase si aggiunge alla lettura degli estratti e si ripartisce tra gli utenti. Il nostro test è impegnativo: ogni utente pone le domande una dopo l'altra senza tempo di lettura, mentre una persona reale legge la risposta prima di porre la successiva.
#Dimensionare per 5-20 persone
Con 10 utenti attivi di continuo, lo stack completa 60 risposte in 441 secondi sulla base di 500 pagine: circa 8 risposte al minuto. Ecco un calcolo a partire da questa misurazione. Un team di 20 persone, ognuna delle quali pone in media una domanda ogni 5 minuti, genera 4 domande al minuto, ovvero la metà di questo throughput. È un ordine di grandezza e non una misurazione: i tuoi utilizzi reali possono essere diversi.
- Fino a 5 persone
- Una risposta in 10 s quando interroga una sola persona; circa 40 s quando tutte e 5 interrogano nello stesso secondo.
- Da 5 a 10 persone
- Circa un minuto per una risposta completa quando tutti e 10 interrogano di continuo, senza alcun errore. Il server è configurato per 10 richieste in parallelo.
- Da 10 a 20 persone
- Non abbiamo misurato più di 10 utenti simultanei. Il calcolo qui sopra suggerisce che 20 persone con un utilizzo abituale restano al di sotto del throughput misurato.
#Riservatezza: cosa abbiamo verificato
Un assistente privato ha senso solo se i documenti restano a casa tua. Abbiamo quindi verificato il traffico di rete. Durante le 200 risposte, 100 su ciascuna base, abbiamo catturato i pacchetti delle due reti Docker dello stack con tcpdump, poi abbiamo elencato tutti gli indirizzi rilevati.
Risultato: nessun container dello stack ha inviato pacchetti verso un indirizzo esterno. Gli unici indirizzi rilevati sono quelli dei container e del gateway della macchina host, oltre a indirizzi multicast e di broadcast locale (messaggi di discovery della rete locale). Open WebUI è collegato a una rete di accesso, eppure non compare alcun indirizzo esterno. I due server dei modelli, invece, si trovano in una rete che Docker isola dall'esterno.
#Energia: 0,15 Wh per risposta
Abbiamo rilevato la potenza della GPU una volta al secondo durante le 100 risposte di ciascuna base, 4 domande alla volta. Su 500 pagine, la GPU ha lavorato 18,0 minuti a 50,5 W in media, con un picco di 68,1 W: 15,2 Wh, ovvero 0,15 Wh per risposta. Su 5 000 pagine, 50,7 W e 15,4 Wh: lo stesso risultato, 0,15 Wh per risposta.
| Situazione | Durata | Potenza media della GPU | Energia della GPU |
|---|---|---|---|
| A riposo, nessuna attività | 30 min | 10,4 W | — |
| 100 risposte, base di 500 pagine, 4 alla volta | 18,0 min | 50,5 W | 15,2 Wh, ovvero 0,15 Wh per risposta |
| 100 risposte, base da 5 000 pagine, 4 alla volta | 18,2 min | 50,7 W | 15,4 Wh, ovvero 0,15 Wh per risposta |
| Indicizzazione delle 5.000 pagine | 6,1 min | 53,2 W | 5,4 Wh |
Con la tariffa EDF Tarif Bleu Base (20,01 centesimi per kWh IVA inclusa, tariffe in vigore dal 1° agosto 2026, abbonamento escluso), 1 000 risposte corrispondono a 0,15 kWh, cioè 3 centesimi. Queste cifre considerano solo la GPU, così come la riporta il chip: secondo NVIDIA, la potenza mostrata da nvidia-smi è quella della sola GPU. Processore, memoria, SSD e alimentatore non sono inclusi. Un'altra guida della serie descrive in dettaglio il consumo nel tempo.
#La qualità delle risposte, valutate una per una
Un indicatore automatico non dice se una risposta è corretta. Le 100 risposte ottenute sulla base di 500 pagine sono state quindi valutate una per una. Su richiesta dell'autore, questa valutazione è stata effettuata da Claude, il modello di IA di Anthropic, e non dal modello che risponde (gpt-oss 120B).
Per ogni domanda, Claude disponeva della risposta attesa, del documento sorgente e della griglia qui sotto. Il voto va da 0 a 2 e giudica la sostanza (cifre, date, nomi, condizioni), non la formulazione. Una fonte assente non cambia il voto; in caso di dubbio, si attribuisce il voto più basso.
| Note | Domanda con risposta nei documenti | Domanda senza risposta nei documenti |
|---|---|---|
| 2 | Corretta e completa: l'informazione principale è esatta, non viene aggiunto nulla di errato. | L'assistente dice che non trova l'informazione nei documenti, senza inventare nulla. |
| 1 | Parziale o incompleta: l'essenziale è corretto, ma manca un elemento importante, oppure un dettaglio secondario è errato. | Esita o risponde fuori tema, senza inventare una risposta. |
| 0 | Errata o inventata: l'informazione principale è errata, contraddice i documenti o non c'entra nulla. | Inventa una risposta: una cifra, una data, un nome o una regola assenti dai documenti. |
| Tipo di domanda | Domande | Punteggio | Corrette e complete |
|---|---|---|---|
| Sintesi: incrociare più documenti | 10 | 95 % | 9 |
| Fatto preciso | 50 | 80 % | 38 |
| Cifra o calcolo | 10 | 80 % | 8 |
| Procedura: tutti i passaggi e tutti i tempi | 10 | 60 % | 3 |
| Senza risposta nei documenti | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
Le domande di sintesi richiedono di incrociare più documenti e di tenere la regola più recente. L'assistente risponde in modo corretto e completo 9 volte su 10. La maggior parte delle risposte sbagliate deriva dalla ricerca del documento, non dalla redazione.
Quando un documento atteso compare tra le fonti (69 domande su 80), 57 risposte sono corrette e complete e il punteggio raggiunge l'88 %. Quando manca (11 domande), la risposta è il più delle volte sbagliata. Questa ricerca dipende dalle impostazioni di Open WebUI (suddivisione dei documenti, numero di estratti), che non abbiamo fatto variare: è la prima leva da regolare sulla tua installazione.
Sulle 20 domande la cui risposta non si trova nei documenti, l'assistente lo dice chiaramente 12 volte. In 5 casi aggiunge un'informazione che non proviene da lì: una stima numerica, una confusione tra due concetti o un numero attribuito in modo errato. Aprire le fonti mostrate sotto la risposta permette di individuare questi casi.
Ogni voto è pubblicato con la sua motivazione, la domanda e la risposta attesa, in un file CSV della nostra pagina dei dati. Le 100 risposte sulla base di 5.000 pagine non sono valutate: le riguarda solo l'indicatore «documento giusto trovato».
#Per chi l'ATOM è la scelta giusta
- Una PMI di 5-20 persone che vuole un assistente sui propri documenti
- Tutto sta su una sola macchina: 68 GB di memoria, 66 secondi di avvio, 5.000 pagine indicizzate in 6 minuti e una risposta in 10 secondi quando interroga una sola persona.
- Uno studio professionale o un ufficio che gestisce documenti sensibili
- Durante le nostre 200 risposte, nessun pacchetto è uscito verso l'esterno. Nella nostra configurazione, i documenti restano sulla macchina.
- Un team che vuole condividere un assistente
- 10 utenti attivi in continuo hanno ricevuto tutti la loro risposta, in circa un minuto, senza alcun errore.
- Un integratore o un reparto IT
- Lo stack si basa su componenti aperti: Docker, Open WebUI, llama.cpp e modelli a pesi aperti; solo il driver, CUDA e i container di NVIDIA sono proprietari. Open WebUI offre anche un'API che il tuo software può chiamare.
Distinguiamo la piattaforma dal produttore. È il chip NVIDIA GB10 a rendere possibili questi risultati: i suoi 128 GB di memoria unificata ospitano un modello da 117 miliardi di parametri (gpt-oss 120B) con il relativo contesto e un modello di embedding, e la sua larghezza di banda dichiarata è di 273 GB/s.
GIGABYTE fornisce il proprio chassis da un litro (1,2 kg) e il proprio raffreddamento a due ventole: durante le 100 risposte su 5 000 pagine, la GPU è rimasta a 66 °C in media e a 72 °C al massimo, senza alcun throttling segnalato.
Prezzi rilevati l'8 ottobre 2026 per l'ATAGB10-9001 (128 GB, SSD da 4 TB PCIe 4.0): 6.346,27 € IVA inclusa sul negozio ufficiale AORUS, dove era esaurita; era disponibile su Amazon.fr. Abbiamo misurato il modello ATAGB10-9000, il cui SSD è PCIe 5.0. I prezzi delle GB10 cambiano ogni settimana: verificali prima di acquistare.
#Ciò che non abbiamo misurato
- Una valutazione umana
- Le risposte sono state valutate da Claude, un modello di IA, e non da una persona. La base da 5 000 pagine non è valutata. Ogni voto è pubblicato con la sua motivazione, così puoi verificarlo.
- Documenti reali
- Il nostro corpus è fittizio, scritto in francese, in formato Markdown e testo. PDF, documenti Word, scansioni e tabelle non sono stati misurati.
- Più di 10 utenti
- Il server è configurato per 10 richieste in parallelo. Non abbiamo misurato oltre, né con account distinti: è stato usato un solo account di test.
- Altre impostazioni
- Non abbiamo fatto variare la suddivisione (impostazione predefinita di Open WebUI) né il numero di estratti (fissato a 5). Altre impostazioni possono modificare la percentuale di casi in cui viene ritrovato il documento giusto.
- Energia
- Riguarda solo la GPU.
Aggiornamenti e correzioni: valutazione delle risposte aggiunta l'8 ottobre 2026; ogni correzione sarà datata.
#FAQ
Quante persone possono usare l'assistente contemporaneamente?+
I miei documenti escono dalla macchina?+
Quante pagine si possono indicizzare, e in quanto tempo?+
Serve la versione da 128 GB dell'ATOM?+
Come verificare una risposta dell'assistente?+
Quanto costa una risposta in elettricità?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.