AI TOP ATOM vs DGX Spark: quali differenze reali?
Una GIGABYTE AI TOP ATOM e un DGX Spark di NVIDIA si basano sullo stesso chip GB10 e sugli stessi 128 GB di memoria. Le nostre misurazioni hanno uno scarto massimo del 4,3% rispetto a quelle pubblicate per il DGX Spark con llama.cpp e del 2% rispetto a Ollama. GIGABYTE fornisce il proprio chassis, dello stesso formato da un litro della Founders Edition, il proprio sistema di raffreddamento e i suoi sei modelli. Durante 2 ore di carico continuo, la velocità è rimasta stabile, senza alcun rallentamento imposto.
Il DGX Spark di NVIDIA e l'AI TOP ATOM di GIGABYTE si basano sullo stesso chip GB10. Che cosa cambia davvero? Sulla nostra AI TOP ATOM, fornita gratuitamente da GIGABYTE, abbiamo ripetuto tre serie di misurazioni pubblicate per il DGX Spark, poi ne abbiamo misurato il comportamento sotto carico per 1 e 2 ore, le temperature e l'SSD, e verificato le porte. Seguono i prezzi per modello e i nostri consigli per l'acquisto.
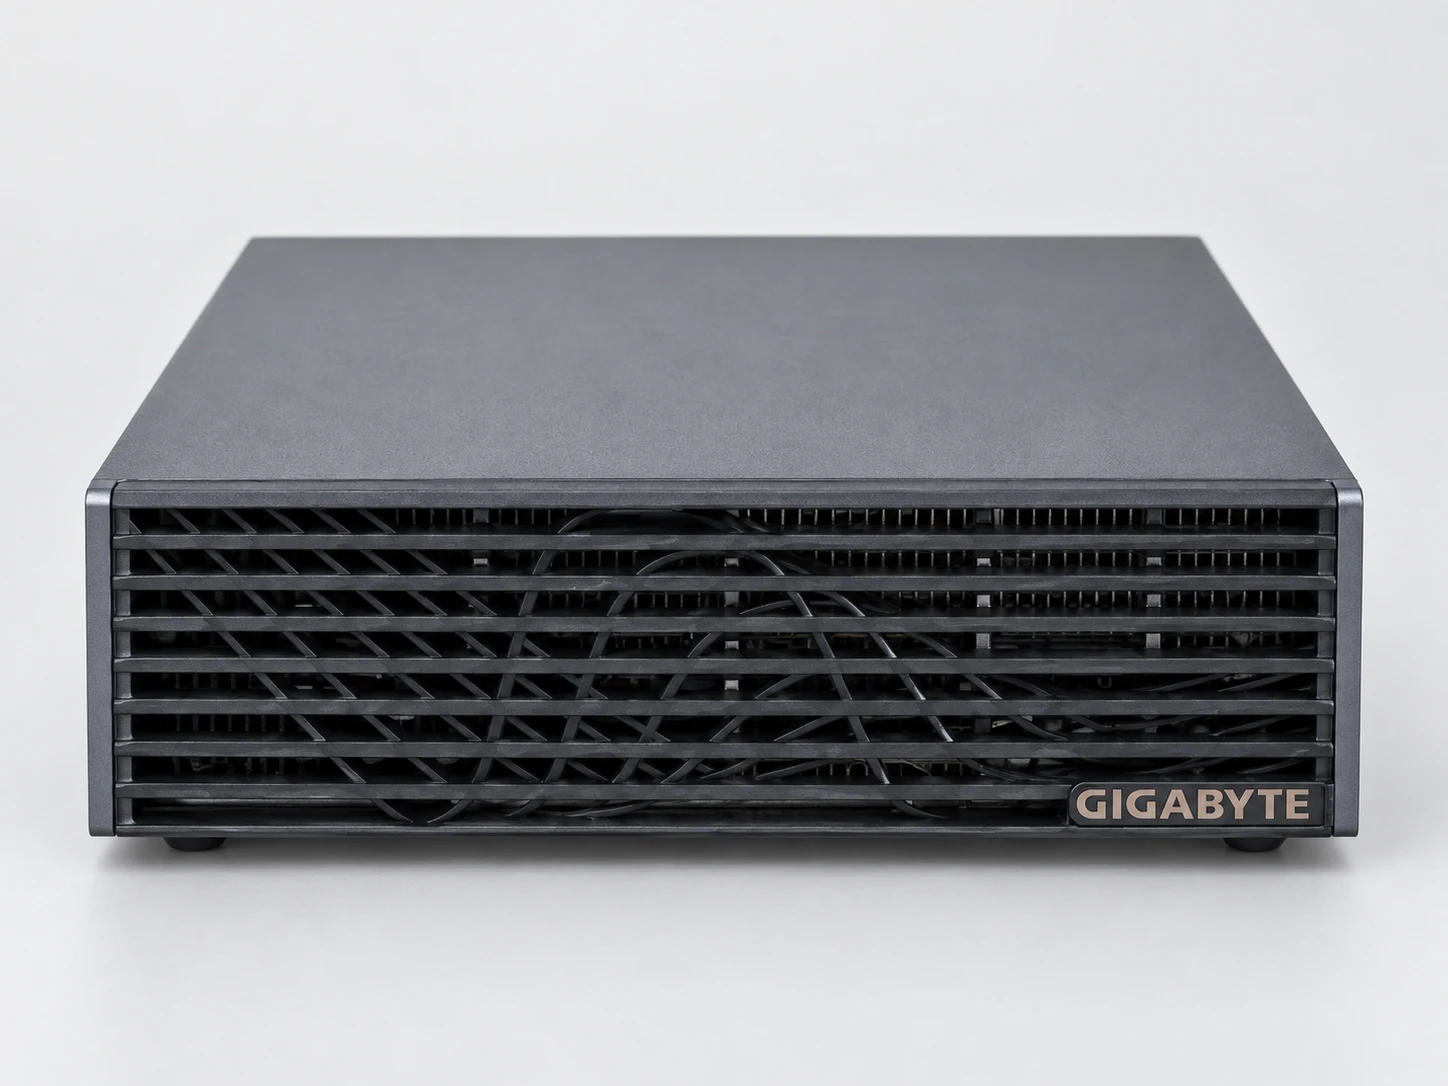
#Stesso chip NVIDIA GB10, produzione GIGABYTE
DGX Spark è una piattaforma di NVIDIA. Il suo chip GB10 riunisce 20 core Arm e una GPU di generazione Blackwell, che condividono 128 GB di memoria con una velocità dichiarata di 273 GB/s. NVIDIA fornisce anche il sistema DGX OS, il driver e CUDA. Il DGX Spark venduto da NVIDIA si chiama Founders Edition. Altri produttori, tra cui GIGABYTE, propongono una propria macchina basata sulla stessa piattaforma.
Questa separazione organizza l'intera guida. Ciò che proviene da NVIDIA si ritrova su tutte le macchine GB10: la sezione seguente lo verifica con misurazioni. Ciò che proviene da GIGABYTE si valuta in base al telaio, al raffreddamento, allo storage, ai modelli e alla garanzia. StorageReview, un sito americano di test hardware, scrive che, poiché tutte queste macchine condividono la stessa base GB10, la differenza di prestazioni nell'IA rimane contenuta.
| Elemento | Fornito da | Sul nostro AI TOP ATOM |
|---|---|---|
| Chip GB10: 20 core Arm, GPU Blackwell | NVIDIA | Velocità inferiori del 5% rispetto a quelle pubblicate (sezione seguente) |
| Memoria unificata da 128 GB, 273 GB/s | NVIDIA (piattaforma) | Il sistema vede 121,7 GB; una parte è riservata all'avvio |
| DGX OS, driver, CUDA | NVIDIA | DGX OS 7.5.0, driver 580.159.03, CUDA 13.0 |
| Formato di 150 × 150 × 50,5 mm e 1,2 kg | Stesso formato della Founders Edition | Scocca nera opaca, pannello frontale a lamelle senza porte né pulsanti |
| Raffreddamento e finitura | GIGABYTE | Dissipatore, piastre di rame, heat pipe e due ventole, secondo ServeTheHome |
| SSD: capacità e generazione PCIe | GIGABYTE (a seconda del riferimento) | Samsung da 4 TB, PCIe 5.0 verificato (32 GT/s su 4 linee) |
| Alimentazione da 240 W tramite USB-C | GIGABYTE (adattatore in dotazione) | NVIDIA richiede di utilizzare l'alimentatore fornito |
| Modelli, prezzi, garanzia | GIGABYTE e rivenditori | Vedi le sezioni riferimenti e prezzi |
#Le stesse velocità del DGX Spark: tre verifiche
Per confrontare l'ATOM con i riferimenti del DGX Spark, abbiamo ripetuto tre misurazioni pubblicate per questa macchina, usando lo stesso strumento. Per llama.cpp e Ollama, anche la versione e le impostazioni sono le stesse; per vLLM, la versione e il comando non sono stati pubblicati. Se il nostro ATOM fornisce gli stessi numeri, offre le stesse prestazioni del riferimento.
#Metodo e unità di misura
Ogni velocità di llama.cpp è la media di 5 ripetizioni, con una deviazione standard inferiore al 3% (la deviazione standard misura la dispersione delle ripetizioni). La velocità di lettura è quella con cui la macchina acquisisce il tuo testo prima di rispondere. La velocità di scrittura è quella della risposta che viene visualizzata.
Entrambe si misurano in token al secondo (tok/s); un token è un frammento di parola, circa due terzi di una parola in francese. La memoria e i trasferimenti del disco sono espressi in GB e GB/s, come li mostra Linux: 1 GB = 1 024 MB.
Il protocollo è stato definito prima della prima misurazione. Ogni test aggiunto in seguito è descritto in un addendum datato, redatto prima del test. Il metodo, l'elenco datato degli addendum e i dati delle nostre tabelle sono pubblicati sulla nostra pagina dedicata al metodo.
#Con llama.cpp: entro il 4,3%
llama.cpp è un motore open source molto diffuso per eseguire modelli in locale. Il progetto pubblica una tabella di riferimento per il DGX Spark, con la build 7941 (il numero di versione del software), nel febbraio 2026. Abbiamo compilato la stessa build ed eseguito lo stesso comando su sei modelli e cinque profondità di contesto, per un totale di 60 punti di misurazione. Il contesto è il testo già presente in memoria: da 0 a 32 768 token.
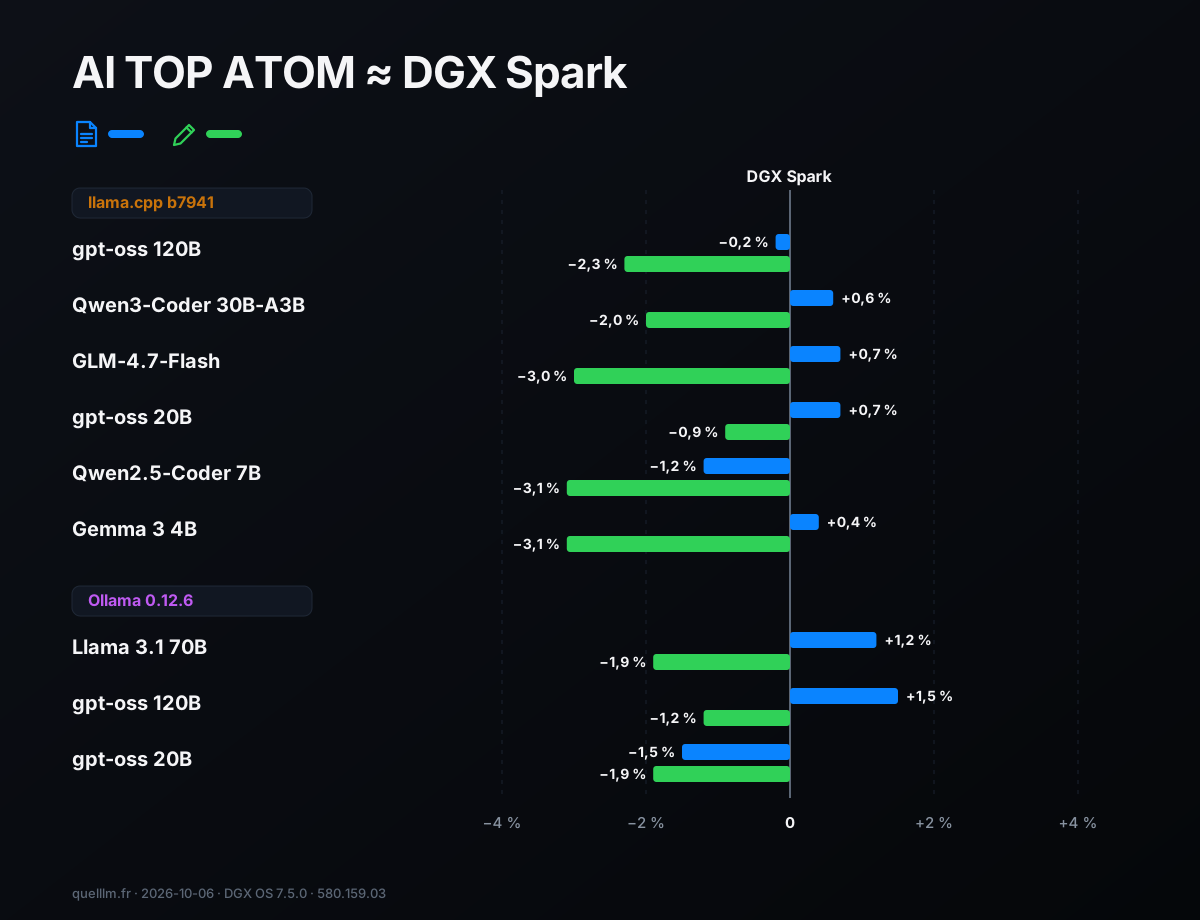
Risultato: la velocità di lettura è identica entro il 2,3%, con uno scarto mediano del +0,3%. La velocità di scrittura resta allo stesso livello, con uno scarto mediano del −2,8% (4,3% al massimo). Per gpt-oss 120B, la lettura a contesto vuoto è uguale al riferimento: 2 443,9 tok/s da entrambe le parti. La tabella di riferimento risale a un driver più vecchio (580.95.05) rispetto al nostro (580.159.03).
#Con lo script ufficiale di Ollama: entro il 2%
Ollama ha pubblicato le proprie misurazioni per il DGX Spark nell'ottobre 2025, con la versione 0.12.6 e il driver 580.95.05. Abbiamo utilizzato la stessa versione e lo stesso script, con 10 passaggi e una temperatura pari a 0. I tre modelli pubblicati danno risultati con uno scarto del 2%, sia in lettura sia in scrittura.
| Modello | Lettura: noi / pubblicato | Scarto | Scrittura: noi / pubblicato | Scarto |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#Con vLLM: stesso ordine di grandezza, motore diverso
StorageReview ha misurato l'ATOM il 3 marzo 2026 con vLLM, un server progettato per rispondere a più persone contemporaneamente, su gpt-oss 120B. StorageReview non pubblica né la versione di vLLM né il comando esatto. Abbiamo ripetuto i suoi tre scenari con vLLM 26.09, per 1 e per 64 utenti.
Le nostre velocità sono dello stesso ordine di grandezza delle sue, superiori o inferiori a seconda dello scenario. Con un utente, nello scenario in cui la macchina legge 4 096 token e ne scrive 512, otteniamo complessivamente 304,4 token al secondo, contro i 304,6 di StorageReview.
Con 64 utenti, nello scenario equilibrato (256 token letti, 256 scritti), raggiungiamo 695 token al secondo, contro 650. Poiché la versione di vLLM non è la stessa, presentiamo queste cifre come dello stesso ordine di grandezza e non come un confronto tra macchine. Durante queste prove, nessuna richiesta è stata interrotta.
In sintesi: con llama.cpp e Ollama, due motori molto utilizzati in locale, l'ATOM offre prestazioni identiche a quelle di un DGX Spark con uno scarto inferiore al 5%. Per la velocità di ciascun modello su questo chip, consultate la nostra prima guida della serie.
#Cosa apporta GIGABYTE: chassis, raffreddamento, riferimenti
L'AI TOP ATOM misura 150 × 150 × 50,5 mm e pesa 1,2 kg, per un volume di circa un litro: è il formato della Founders Edition. Il case è nero opaco. Il pannello frontale è a lamelle, con un motivo ondulato, e non presenta né porte né pulsanti: tutto si collega sul retro.
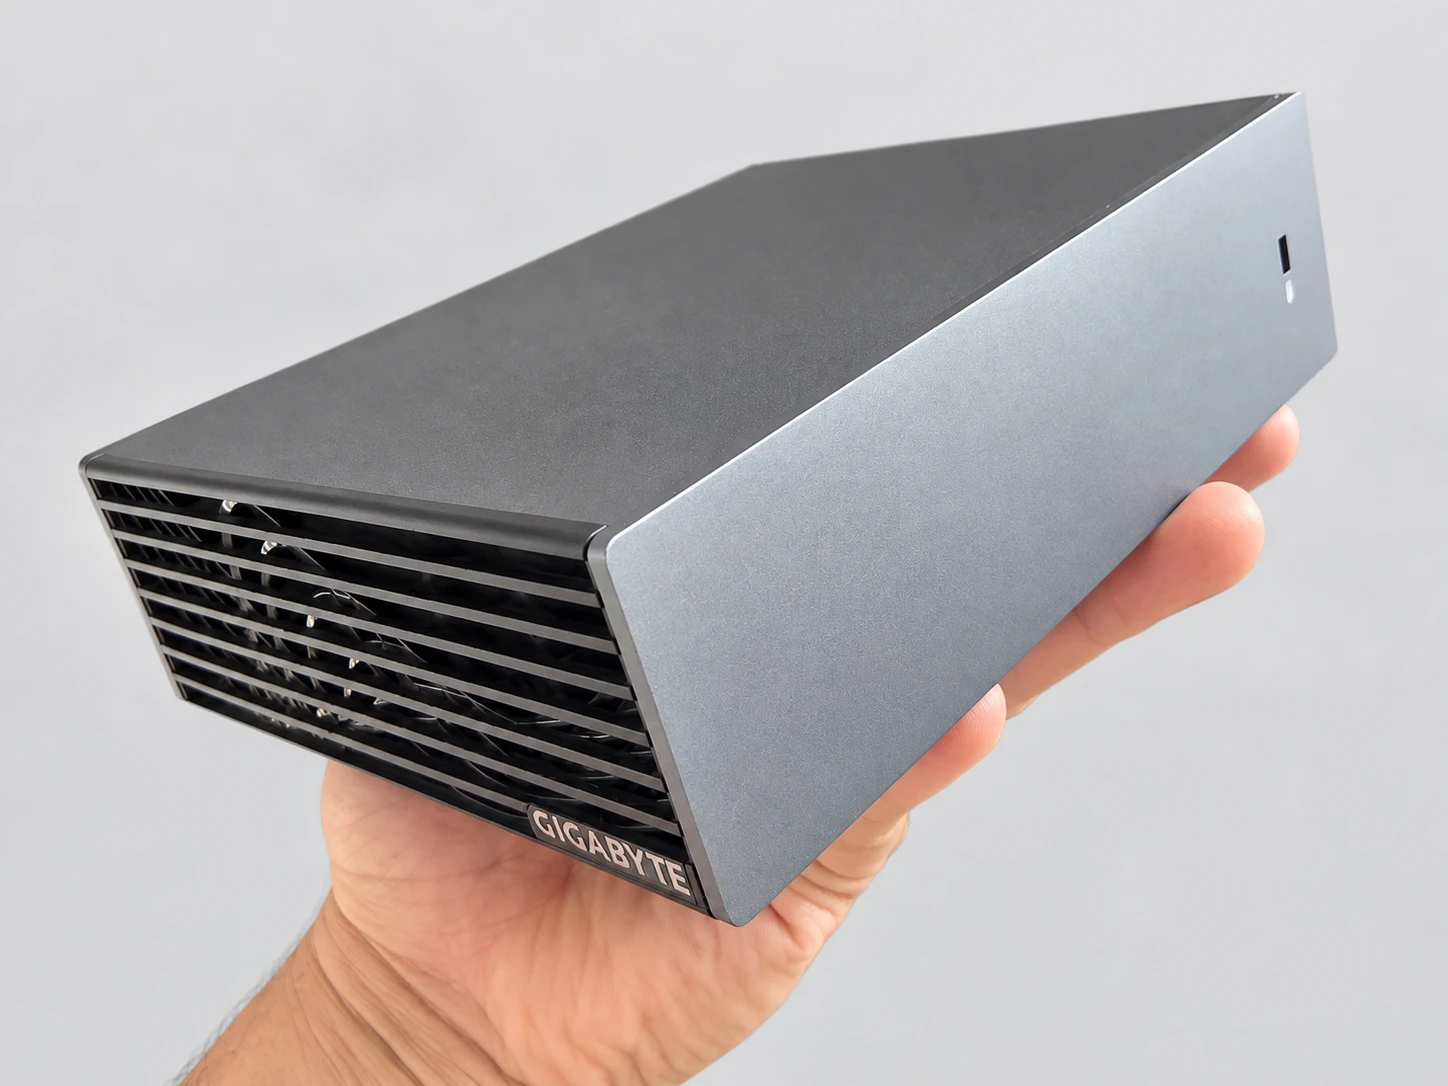
ServeTheHome ha aperto la macchina. Descrive un grande dissipatore, con piastre di rame sui chip e heatpipe, raffreddato da due ventole Delta. StorageReview ha confrontato cinque macchine GB10 a gennaio 2026. GIGABYTE raggiunge al massimo 87-88 °C nei picchi di carico, come la Founders Edition e la macchina Dell.
StorageReview la colloca tra i migliori profili di raffreddamento, con uno dei livelli di potenza GPU più elevati. Dopo più di un'ora di riscaldamento, ServeTheHome trova l'ATOM allo stesso livello della DGX Spark di NVIDIA, con un leggero vantaggio in diversi suoi test di IA.
Peter Falkingham, che usa un ATOM da luglio 2026 per un laboratorio universitario, lo descrive nel suo test come quasi silenzioso.
#Sei modelli di riferimento, con un SSD a scelta
La pagina prodotto di GIGABYTE elenca sei riferimenti, da ATAGB10-9000 a ATAGB10-9005. La tabella riporta quelli che abbiamo potuto verificare.
| Riferimento | Memoria | SSD |
|---|---|---|
| ATAGB10-9000 (la nostra unità) | 128 GB | 4 TB in PCIe 5.0 |
| ATAGB10-9001 | 128 GB | 4 TB in PCIe 4.0 |
| ATAGB10-9002 | 128 GB | 1 TB su PCIe 4.0 |
| ATAGB10-9003 a 9005 | 128 GB o 64 GB | 2 TB o 1 TB in PCIe 4.0 (non verificato modello per modello) |
Sulla 9000, l'SSD è un Samsung della famiglia PM9E1, lo stesso modello della Founders Edition secondo StorageReview. È un modulo M.2 2242. Secondo ServeTheHome, è l'unico componente che l'utente può sostituire.
#Alimentazione, confezione e garanzia
L'adattatore da 240 W si collega alla porta USB-C riservata all'alimentazione. NVIDIA richiede di utilizzare l'alimentatore fornito per ottenere prestazioni ottimali. La confezione contiene la macchina, l'adattatore e il cavo di alimentazione. Un cavo QSFP per collegare due macchine è venduto separatamente da GIGABYTE: 94,04 € IVA inclusa nel negozio ufficiale AORUS (rilevazione dell'8 ottobre 2026).
Per la garanzia, il manuale di GIGABYTE indica che la durata è specificata sul sito del prodotto o sulla sua etichetta. LDLC annuncia 5 anni di garanzia sul 9000 (rilevazione dell'8 ottobre 2026). Leggi la durata nella scheda del rivenditore prima di acquistare.
#Porte e connettività
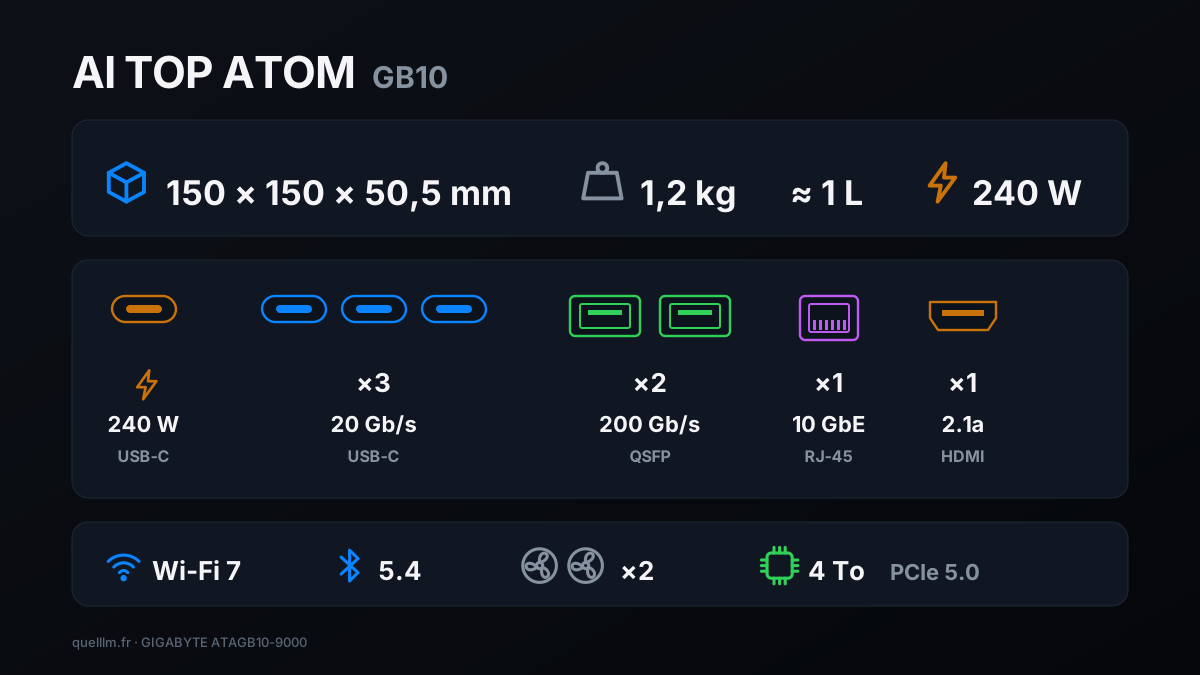
L'elenco riprende la scheda di GIGABYTE, mentre la scheda di NVIDIA per la Founders Edition indica le stesse porte. Sulla nostra unità abbiamo verificato la rete cablata e il collegamento dell'SSD, oltre a identificare il modulo Wi-Fi.
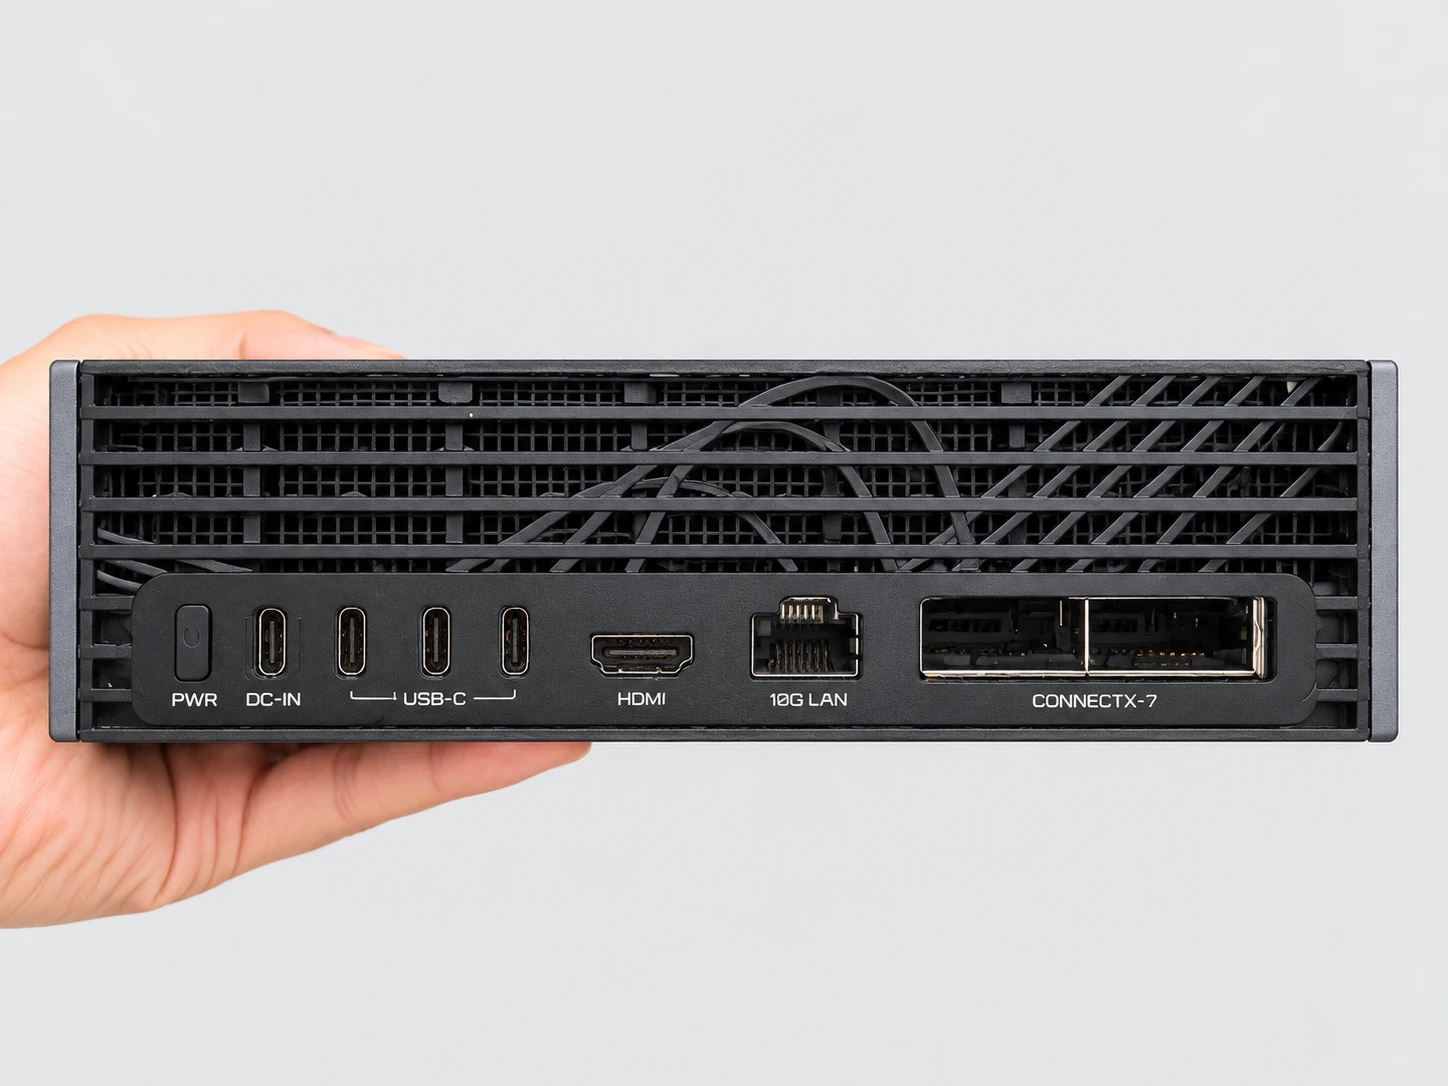
- Alimentazione
- Una porta USB-C riservata all'alimentazione, con l'adattatore da 240 W in dotazione.
- USB
- Tre porte USB-C a 20 Gb/s (USB 3.2 Gen 2x2) per dischi e accessori.
- Rete cablata
- Una porta RJ-45 10 GbE. Sulla nostra unità, il collegamento negoziato è di 10 Gb/s.
- Rete ad alta velocità
- Due porte QSFP (scheda NVIDIA ConnectX-7, 200 Gb/s) per collegare più macchine. Non abbiamo testato questo collegamento.
- Video
- Un'uscita HDMI 2.1a, con audio multicanale.
- Wireless
- Wi-Fi 7 e Bluetooth 5.4. Il nostro sistema identifica un chip MediaTek MT7925.
#Tenuta sotto carico: 1 ora e 2 ore consecutive
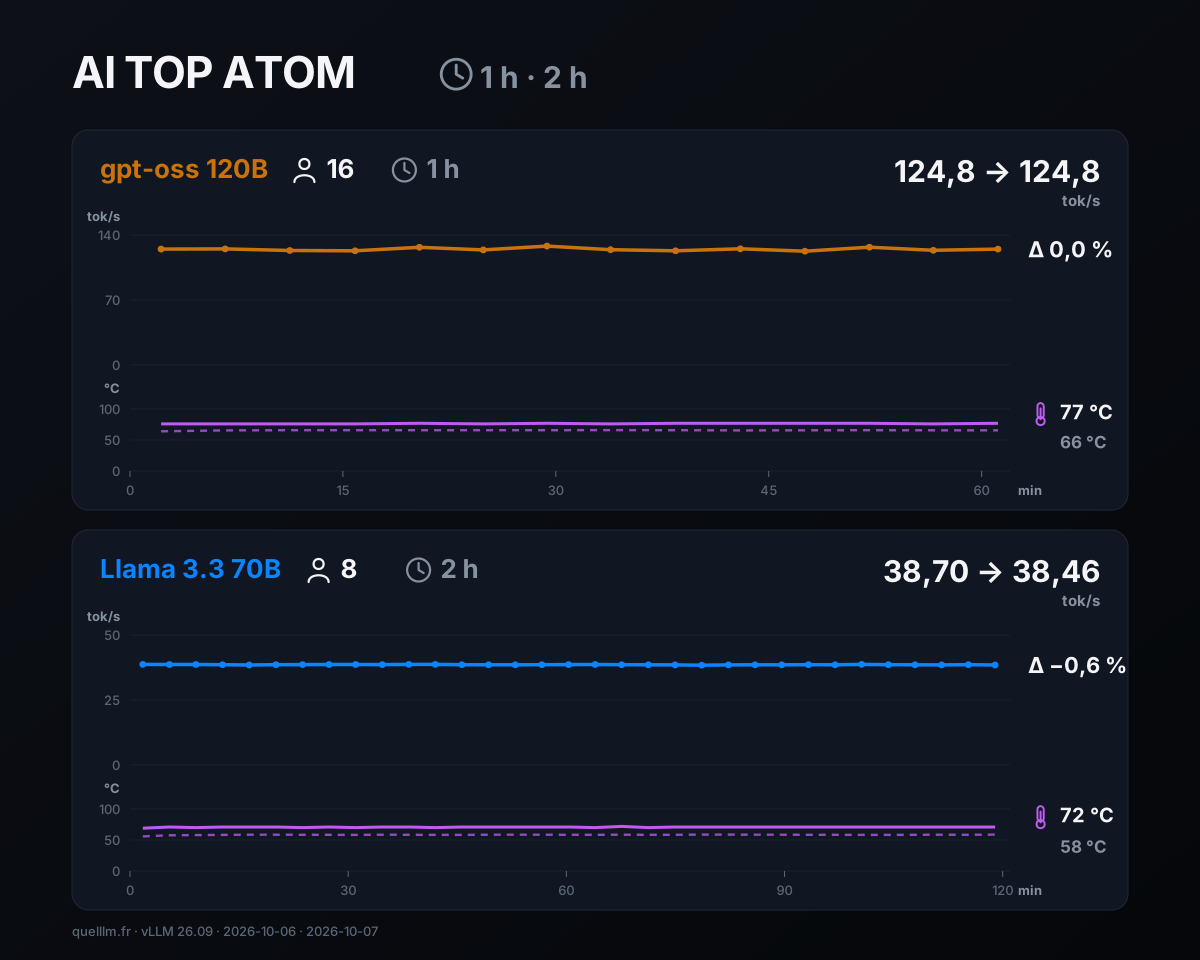
Una macchina compatta deve sostenere il carico senza rallentare. Un rallentamento imposto dal calore o dal limite di potenza si chiama throttling. Abbiamo fatto lavorare l'ATOM senza pause con vLLM 26.09. Ogni sessione è suddivisa in tranche: una tranche è un lotto di richieste inviato subito dopo il precedente. Nel frattempo abbiamo rilevato ogni secondo la frequenza di clock della GPU, la sua potenza, la sua temperatura e le cause del throttling dichiarate dal driver.
| Sessione | Richieste | Velocità: dalla prima all'ultima porzione | Deriva | Temperatura della GPU | Bridage |
|---|---|---|---|---|---|
| 1 h, gpt-oss 120B, 16 utenti, 14 tranche | 896, nessun errore | 124,8 → 124,8 (da 122,6 a 128,1) | 0,0 % | 77 °C / 66 °C | Nessuno |
| 2 h, Llama 3.3 70B NVFP4, 8 utenti, 33 intervalli | 1 056, nessun errore | 38,70 → 38,46 (da 38,40 a 38,70) | −0,6 % | 72 °C / 58 °C | Nessuno |
Per un'ora, 16 utenti hanno inviato continuamente richieste da 4 096 token, con risposte da 512 token. I 14 intervalli da 64 richieste hanno prodotto un throughput quasi identico, da 122,6 a 128,1 tok/s complessivi, e sia il primo sia l'ultimo hanno raggiunto 124,8 tok/s. Ogni persona vedeva la propria risposta essere scritta a circa 8 tok/s. In questa sessione, la frequenza della GPU ha avuto una mediana di 2 509 MHz.
Per due ore, 8 utenti hanno lavorato su Llama 3.3 70B in formato NVFP4, un formato compresso di NVIDIA, con 1 024 token letti e 256 scritti per richiesta. Il throughput totale è rimasto tra 38,40 e 38,70 tok/s su 33 intervalli da 32 richieste.
La deriva è dello −0,6% tra il primo e l'ultimo intervallo e dello −0,2% confrontando le mediane dei primi cinque e degli ultimi cinque. Ogni persona vedeva la propria risposta essere scritta a circa 5,1 tok/s e la prima parola arrivava in 2,8 s (mediana). La frequenza della GPU ha avuto una mediana di 2 528 MHz.
Il driver non ha segnalato alcun motivo di limitazione durante le due sessioni: il valore rilevato è rimasto pari a zero, secondo dopo secondo. La GPU ha raggiunto al massimo 77 °C con 16 utenti e 72 °C con 8 utenti. La zona più calda dei sensori del sistema ha raggiunto 87 °C durante la prima sessione e 80 °C durante la seconda.
Durante la seconda, l'SSD ha raggiunto al massimo 49 °C. Il firmware non denomina queste zone: non le attribuiamo al processore. Per confronto, StorageReview ha rilevato al massimo 87-88 °C nei picchi di carico sulla Founders Edition, sulla macchina Dell e sulla GIGABYTE.
#A riposo
Dopo 20 minuti di inattività, abbiamo monitorato la macchina per 30 minuti. La GPU consuma in media 10,4 W (da 10,2 a 11,0 W) e rimane tra 35 e 36 °C. La zona più calda tra i sensori del sistema raggiunge al massimo 46 °C, mentre l'SSD rimane tra 34 e 35 °C. Non è stata dichiarata alcuna ragione per il throttling.
La potenza indicata è quella della GPU, rilevata dai suoi sensori; non rappresenta il consumo totale della macchina. La temperatura ambiente non è stata registrata. La sessione di un'ora si è svolta all'inizio della serata e quella di 2 ore durante la notte, quando la stanza probabilmente è più fresca.
#L'SSD: 13 GB/s in lettura, 1,28 milioni di IOPS
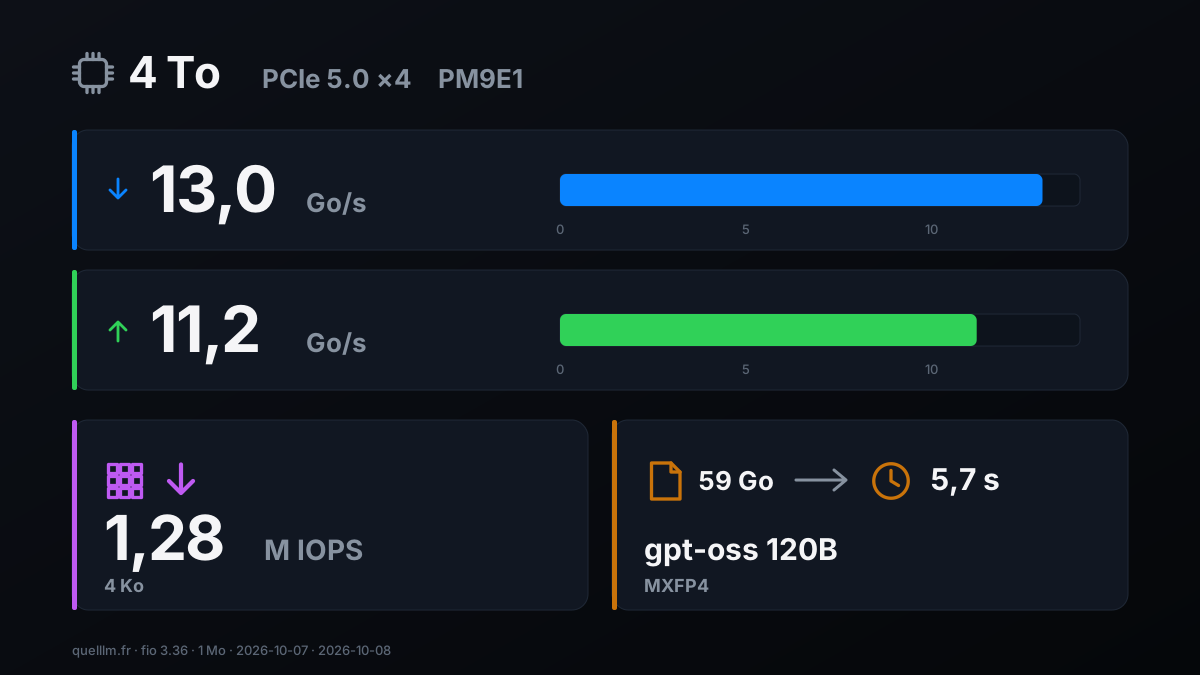
Il modello 9000 incorpora un SSD Samsung MZALC4T0HBL1 da 4 TB della famiglia PM9E1. Il sistema conferma un collegamento PCIe 5.0: 32 GT/s su 4 linee. PCIe è il collegamento tra l'SSD e il chip; la versione 5.0 è due volte più veloce della 4.0.
Lo abbiamo misurato con fio 3.36, su un file da 64 GB scritto interamente prima della lettura, in accesso diretto, cioè senza passare dalla cache del sistema. Gli IOPS sono il numero di operazioni di lettura o scrittura al secondo.
| Test | Risultato |
|---|---|
| Lettura sequenziale, blocchi da 1 MB, 1 attività | 13,0 GB/s (12,99 con io_uring, 13,37 con libaio, due metodi di accesso al disco di Linux) |
| Lettura casuale, blocchi da 4 KB, 4 attività | 1,28 milioni di IOPS con io_uring, 1,19 milioni con libaio (circa 4,9 GB/s con io_uring) |
| Scrittura sequenziale a raffica, blocchi da 1 MB, file nuovo da 32 GB, disco a riposo | 11,2 GB/s |
| Lettura del file di gpt-oss 120B (59 GB) | 5,7 s |
StorageReview ha pubblicato, con un altro strumento (gdsio) e lo stesso modello di SSD, valori da 11,0 a 11,6 GB/s in lettura e 12,2 GB/s in scrittura. I nostri valori sono dello stesso ordine di grandezza, con una lettura leggermente più alta. In pratica, un modello di grandi dimensioni si carica in pochi secondi: il file di gpt-oss 120B, da 59 GB, è stato letto in 5,7 s.
Sulla 9000 ritrovi l'SSD della Founders Edition da 4 TB: è lo stesso modello, quindi non distingue l'ATOM dal riferimento NVIDIA. La differenza esiste tra i riferimenti GIGABYTE: la 9000 ha un SSD PCIe 5.0, la 9001 e la 9002 un SSD PCIe 4.0. Le rilevazioni dell'SSD riguardano il riferimento 9000.
#64 o 128 GB?
Il 2 ottobre 2026, NVIDIA ha annunciato un DGX Spark da 64 GB per modelli fino a 100 miliardi di parametri, disponibile il 23 ottobre presso Acer, ASUS, Dell, GIGABYTE, HP e MSI, a partire da 4.999 dollari. GIGABYTE ha confermato il 5 ottobre un AI TOP ATOM da 64 GB con lo stesso design. La disponibilità in Francia non è confermata a oggi. Non l'abbiamo misurata.
I nostri rilevamenti della prima guida della serie permettono di fare un calcolo. I modelli fino a Qwen3-Coder 30B-A3B occupano meno di 35 GB con 32 768 token di contesto e starebbero in 64 GB. Llama 3.3 70B (51 GB) sarebbe al limite. gpt-oss 120B (62 GB) e i modelli più grandi non ci starebbero. A parità di larghezza di banda, cosa che bisognerà verificare, le velocità dovrebbero essere simili.
Per eseguire un modello con più di 100 miliardi di parametri su una sola macchina, è necessaria la versione da 128 GB. I sei riferimenti della pagina GIGABYTE permettono di scegliere la memoria e l'SSD.
#Prezzo per riferimento (rilevazioni dell'8 ottobre 2026)
I prezzi del GB10 cambiano ogni settimana: verificali prima di acquistare. Ecco ciò che abbiamo rilevato l'8 ottobre 2026 in Francia, IVA inclusa. Confronta sempre lo stesso modello: il 9001 (PCIe 4.0) e il 9000 (PCIe 5.0) non sono la stessa macchina.
| Marchand | Riferimento | Prezzo IVA inclusa | Disponibilità indicata |
|---|---|---|---|
| Negozio ufficiale AORUS | 9001 (4 TB in PCIe 4.0) | 6 346,27 € | Esaurita |
| Amazon.fr, venduto da Amazon UK | 9001 (4 TB in PCIe 4.0) | Prezzo variabile, da leggere su Amazon.fr | 1 esemplare |
| LDLC | 9000 (4 TB in PCIe 5.0) | 7 999,95 € | Rupture |
| Rue du Commerce, venditori terzi | 9000 (4 TB in PCIe 5.0) | A partire da 7 999,95 € (3 offerte) | A seconda del venditore |
| Senetic.fr | 9000 (4 TB in PCIe 5.0) | 9 022,08 € | 5 unità |
Materiel.net esponeva lo stesso prezzo di LDLC per la 9000, anch'essa esaurita. Per fare un confronto, lo stesso giorno la MSI EdgeXpert, un'altra macchina GB10, era esposta a 6 599,95 € da Materiel.net, anch'essa esaurita; la DGX Spark di PNY non era più proposta lì né da LDLC. Un prezzo esposto per una macchina non disponibile non è un prezzo d'acquisto: controllate anche la disponibilità.
#Ciò che non abbiamo misurato
- Il confronto con il DGX Spark
- Il confronto si basa sulle misurazioni pubblicate per il DGX Spark, ripetute sull'ATOM con le versioni software indicate.
- Il rumore
- La valutazione del rumore citata in questa pagina proviene dal test di Peter Falkingham.
- Il consumo dell'intera macchina
- I consumi indicati in questa pagina riguardano solo la GPU. Una guida successiva della serie illustra il consumo.
- La temperatura della stanza
- Le temperature pubblicate provengono dai sensori integrati nella macchina.
- Il collegamento tra due macchine
- Le due porte QSFP (200 Gb/s) non sono state testate.
- Gli altri modelli e la versione da 64 GB
- Le misurazioni riguardano il modello ATAGB10-9000 da 128 GB.
Questa pagina verrà aggiornata se una nuova versione di DGX OS, del firmware o dei nostri strumenti modificherà questi risultati; ogni correzione sarà datata.
#Per chi AI TOP ATOM è la scelta giusta
Quanto segue deriva dalle nostre misurazioni sulla 9000 di riferimento e dalle nostre rilevazioni dei prezzi dell'8 ottobre 2026.
- Vuoi le prestazioni di riferimento del GB10 in un case curato
- Il 9000 offre velocità entro un massimo del 4,3% rispetto a quelle pubblicate per il DGX Spark, con un SSD da 4 TB su PCIe 5.0 misurato a 13 GB/s in lettura.
- … tieni la macchina sulla tua scrivania
- Sta in un litro, pesa 1,2 kg e ha un pannello frontale essenziale. In idle, la GPU consuma circa 10 W.
- … servite un team o agenti di IA
- Un'ora con 16 utenti su gpt-oss 120B, poi due ore con 8 utenti su Llama 3.3 70B: la velocità è rimasta stabile (deriva dello 0,0% e dello −0,6%), senza alcuna limitazione.
- … vuoi pagare meno senza cambiare chip
- La 9001, con un SSD da 4 TB in PCIe 4.0, era indicata a 6 346,27 € nel negozio ufficiale AORUS l'8 ottobre 2026, esaurita, e disponibile su Amazon.fr. Ha lo stesso chip e gli stessi 128 GB; le rilevazioni di questa pagina riguardano il modello 9000.
- … i tuoi modelli occupano meno di 35 GB con il loro contesto
- La versione da 64 GB, annunciata per il 23 ottobre 2026, dovrebbe essere sufficiente (calcolo tratto dalla nostra prima guida, non misurato su questa versione). Attendi che sia disponibile e il suo prezzo.
- … vuoi collegare più macchine
- Le due porte QSFP (200 Gb/s) sono previste per questo uso. GIGABYTE vende il cavo separatamente.
#FAQ
L'AI TOP ATOM è veloce quanto un DGX Spark di NVIDIA?+
Che cosa cambia concretamente tra una ATOM e una Founders Edition?+
AI TOP ATOM rallenta quando lavora a lungo?+
Quale modello scegliere: 9000, 9001 o 9002?+
Conviene aspettare la versione da 64 GB?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.