GB10, Ryzen AI Max+ 395 o Mac: chi è il più veloce?
A parità di motore (llama.cpp), l'AI TOP ATOM, con il suo chip NVIDIA GB10, legge i prompt da 2,1 a 2,8 volte più velocemente del Ryzen AI Max+ 395 e il 23 % più velocemente del Mac M5 Max sul modello di riferimento pubblicato. In scrittura è al livello del Ryzen (dal 4 al 15 % avanti a seconda del modello). Il Mac M5 Max scrive circa due volte più velocemente su un piccolo modello denso: 119,9 contro 59,4 tok/s (token al secondo).
Tre famiglie di macchine offrono 128 GB di memoria per l'IA locale: il GB10 di NVIDIA, di cui l'AI TOP ATOM di GIGABYTE è una versione, il Ryzen AI Max+ 395 di AMD (nome in codice Strix Halo) e il Mac M5 Max di Apple. Abbiamo misurato la nostra AI TOP ATOM, fornita gratuitamente da GIGABYTE, con gli stessi comandi delle misurazioni pubblicate per le altre due, indicando versione del software e data. Ecco in cosa eccelle ciascuna e quale acquisto è adatto a quale uso.
#Come abbiamo confrontato tre macchine?
Per confrontare i riferimenti pubblicati del Ryzen AI Max+ 395 e del Mac con le misurazioni dell'ATOM, abbiamo ripreso il formato esatto di misurazioni già pubblicate. Il primo test fa leggere 512 token (un token è un pezzo di parola) alla macchina, poi gliene fa scrivere 128 («pp512» e «tg128» in llama-bench, lo strumento di misurazione di llama.cpp, un motore open source molto diffuso per i modelli locali).
Questo test è stato pubblicato per un Mac M5 Max nella discussione n. 4167 di llama.cpp e, da kyuz0, un contributore indipendente, per un Framework Desktop con Ryzen AI Max+ 395 e 128 GB. Il secondo test misura la velocità quando 32 768 token sono già in memoria. È quello della discussione n. 16578 di llama.cpp, e kyuz0 lo pubblica anche per il Ryzen.
Il nostro protocollo è stato fissato il 6 ottobre 2026 alle 13:30, prima della prima misurazione. Un'integrazione dello stesso giorno, alle 23:45, ha aggiunto questo formato di confronto.
Le misurazioni di lettura a 512 token e di scrittura a 128 token risalgono al 7 ottobre alle 22:38: cinque ripetizioni per modello, llama.cpp build 11430, Flash Attention attivata come nelle misurazioni di kyuz0, macchina senza altri carichi di lavoro in corso. Le misurazioni a 32.768 token risalgono al 6 ottobre. Il metodo, le impronte dei file e i dati delle nostre tabelle sono pubblicati nella nostra pagina sul metodo.
Le velocità sono in token al secondo (tok/s). Un token è un frammento di parola: in francese vale circa due terzi di parola. Le dimensioni della memoria sono in GB (1 GB = 1.024 MB, come le mostra Linux); le larghezze di banda della memoria in GB/s sono quelle dichiarate dai produttori, in unità decimali. Ecco i comandi usati sull'ATOM:
Una precisazione: la build è il numero di versione di llama.cpp, e le tre macchine non usano la stessa. Il Ryzen è stato misurato con le build b9187 o b9193 a maggio 2026, il Mac con la b10621 ad agosto, l'ATOM con la b11430 a ottobre.
Una build più recente può essere più veloce. Per correttezza, per il test a 32.768 token riportiamo anche i nostri dati con la build 7941 di febbraio 2026, più vecchia di quella del Ryzen (nessuna misurazione pubblicata per il Mac in questo formato).
#Tre macchine da 128 GB: cosa cambia?
Approfitta della nostra esperienza e di un percorso guidato per scegliere gli strumenti adatti al tuo Mac e usare la tua IA ogni giorno.
- Spazio online a vita
- PDF + file
- Garanzia di rimborso di 30 giorni
Il GB10 di NVIDIA riunisce 20 core Arm e una GPU Blackwell attorno a 128 GB di memoria unificata (condivisa da processore e GPU), con una larghezza di banda dichiarata di 273 GB/s. Anche il Ryzen AI Max+ 395 di AMD (nome in codice Strix Halo) condivide 128 GB tra processore e GPU, con circa 256 GB/s in teoria. L'M5 Max di Apple arriva fino a 128 GB, con 614 GB/s e una GPU a 40 core.
| Macchina | Chip | Memoria | Larghezza di banda |
|---|---|---|---|
| AI TOP ATOM (GIGABYTE) | NVIDIA GB10: 20 core Arm e GPU Blackwell | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395 (numeri pubblicati su un Framework Desktop) | AMD Strix Halo | 128 GB LPDDR5x | circa 256 GB/s (teorici) |
| Mac M5 Max | Apple M5 Max: GPU a 40 core | fino a 128 GB | 614 GB/s |
Per scrivere ogni token, il chip rilegge dalla memoria i pesi attivi del modello (i parametri usati in quel momento): la scrittura dipende quindi dalla larghezza di banda, mentre la lettura, che elabora molti token alla volta, dipende dalla potenza di calcolo della GPU.
Il GB10 e il Ryzen hanno una larghezza di banda simile, e così anche le loro velocità di scrittura. L'M5 Max offre 2,25 volte la larghezza di banda dell'ATOM (614 contro 273 GB/s): sull'unico modello denso pubblicato, llama 7B, scrive circa due volte più velocemente.
Per quanto ne sappiamo, tutte le macchine GB10 da 128 GB condividono lo stesso chip NVIDIA. Le velocità di questa guida sono quindi quelle della piattaforma. Ciò che GIGABYTE aggiunge è lo chassis da un litro (1,2 kg), il raffreddamento, le finiture e i modelli commerciali.
Per verificare che la nostra unità restituisca davvero le velocità della piattaforma, abbiamo rifatto la tabella pubblicata dal progetto llama.cpp per il DGX Spark di NVIDIA, la macchina di riferimento della piattaforma (build 7941, febbraio 2026). Su sei modelli e 60 punti di misura, le nostre letture sono a +0,3 % di mediana (da −1,8 % a +2,3 %) e le nostre scritture a −2,8 % di mediana (da −4,3 % a −0,3 %): le due macchine sono allo stesso livello.
#Chi legge più velocemente?
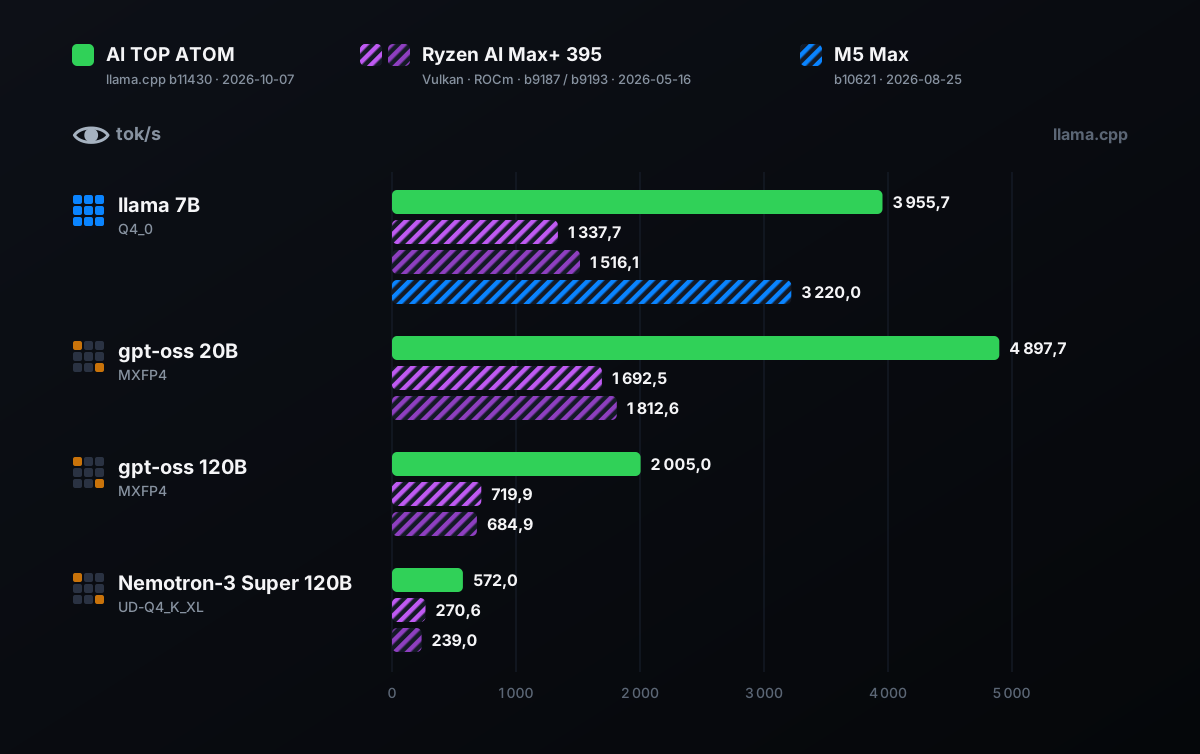
La lettura è il punto di forza dell'ATOM. La tabella riporta i quattro modelli che abbiamo potuto confrontare esattamente, cioè con lo stesso modello e la stessa compressione per ogni macchina. «llama 7B» indica Llama 2 da 7 miliardi di parametri, il modello di riferimento di queste pubblicazioni: è un modello denso (usa tutti i suoi parametri a ogni token), mentre gli altri tre sono modelli MoE (ne attivano solo una parte).
| Modello | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / miglior Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B (MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B (MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
Su questi quattro modelli, l'ATOM legge da 2,1 a 2,8 volte più velocemente del migliore dei due stack software del Ryzen AI Max+ 395 (Vulkan e ROCm sono due modi per far calcolare la GPU di AMD). Su gpt-oss 120B legge 2 005 token al secondo: un prompt di 2 000 token, cioè circa 1 300 parole, viene assorbito in un secondo.
Rispetto al Mac, abbiamo un solo termine di confronto pubblicato in formato llama-bench: il modello di riferimento della discussione n. 4167 di llama.cpp sui chip Apple, llama 7B (Llama 2 da 7 miliardi di parametri) in Q4_0. L'ATOM legge 3.955,7 token al secondo, contro i 3.220,0 dell'M5 Max: il 23% in più.
Con Ollama (uno strumento che esegue modelli in locale), su un documento di circa 17 000 token, la nostra prima guida della serie misura 1 816 tok/s su gpt-oss 120B per l'ATOM, contro 1 388 per un MacBook Pro M5 Max misurato da un lettore, su un testo simile ma non identico (16 850 token per l'ATOM, 16 689 per il Mac): il 31 % in più.
Perché l'ATOM legge così velocemente? La lettura è soprattutto calcolo, e la GPU Blackwell del GB10 ha core dedicati ai calcoli di IA (i «Tensor Core» di NVIDIA). È il criterio che conta per un report di cinquanta pagine, un repository di codice o un agente che rilegge la propria cronologia prima di ogni risposta.
Due avvertenze di lettura. Innanzitutto, le build sono diverse (10621 per il Mac, 11430 per l'ATOM): prendi lo scarto del 23 % come ordine di grandezza. Poi, i due modelli più piccoli (llama 7B e gpt-oss 20B) variano dal 3 al 5 % da una ripetizione all'altra, perché questo test dura circa un decimo di secondo. Due serie distinte danno comunque medie entro l'1 %: 3 955,7 e 3 920,2 per llama 7B, 4 897,7 e 4 905,2 per gpt-oss 20B.
#Chi scrive più velocemente?
La scrittura è il ritmo con cui viene mostrata la risposta. Segue la larghezza di banda della memoria, che varia da una macchina all'altra.
| Modello | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / miglior Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B (MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B (MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
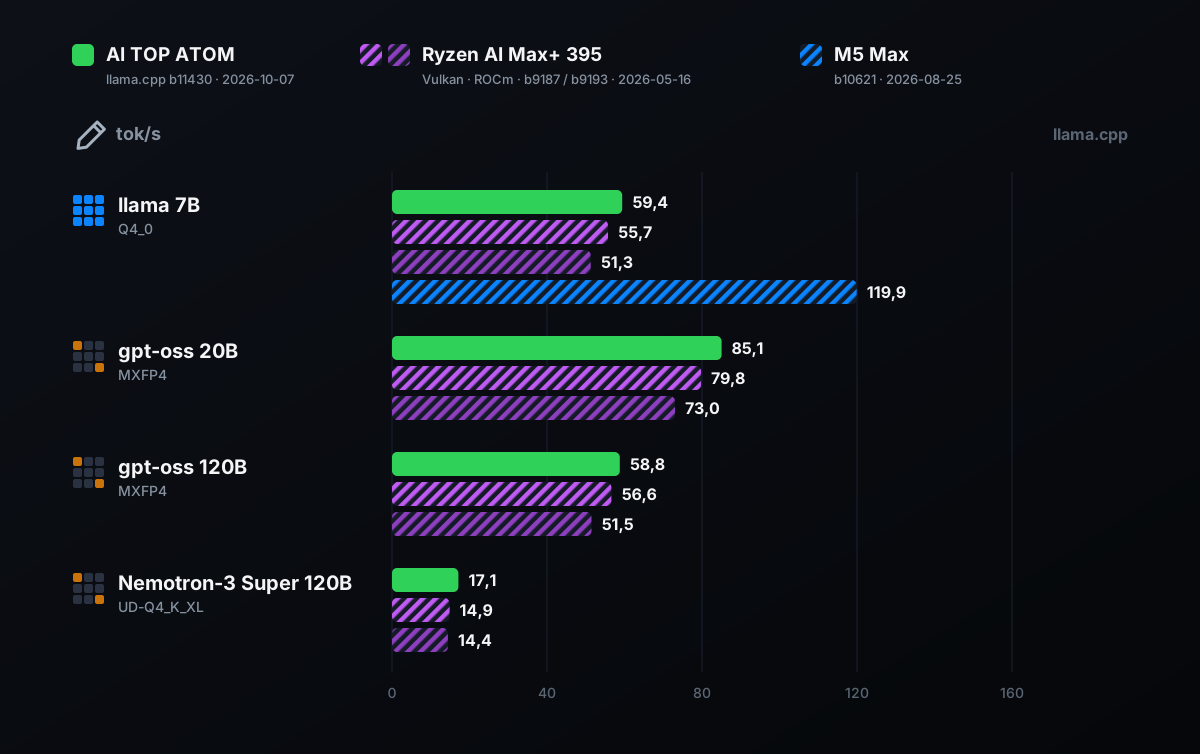
Rispetto al miglior stack software del Ryzen AI Max+ 395, l'ATOM scrive dal 4 al 7 % più velocemente su tre modelli e il 15 % più velocemente su Nemotron-3 Super 120B. È un livello vicino: le due memorie hanno una larghezza di banda simile e le build sono diverse.
Su gpt-oss 120B, un modello da 117 miliardi di parametri, l'ATOM scrive 58,8 token al secondo su 128 token (58,0 su 32 token nella nostra prima guida), il che è molto fluido per una conversazione; il Ryzen ne scrive 56,6 al massimo.
Il Mac M5 Max scrive più velocemente, circa il doppio su un piccolo modello denso (119,9 contro 59,4 token al secondo), grazie alla sua memoria da 614 GB/s, cioè 2,25 volte quella dell'ATOM.
Su un modello denso, il software può accelerare la scrittura. Con un piccolo modello «bozza» che propone token che il modello grande convalida in un colpo solo (la decodifica speculativa), Llama 3.3 70B passa sull'ATOM da 4,7 a 12 token al secondo su testo in francese (8 parole di anticipo), e fino a 18,7 sul codice (16 parole di anticipo): da 2,6 a 4 volte più veloce (llama-server b11430, bozza Llama 3.2 1B, 6 e 7 ottobre 2026). Questa tecnica esiste anche sulle altre macchine; lì non l'abbiamo misurata.
#Cosa succede con un documento lungo?
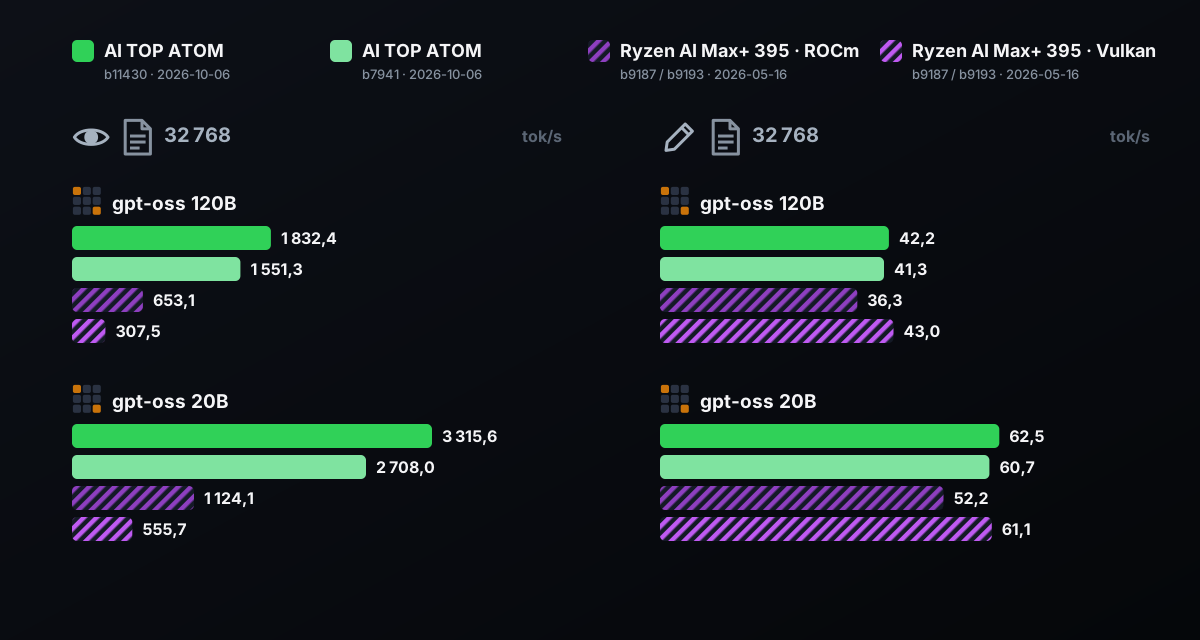
Più è lungo il testo già presente, più rallenta il seguito. Il test a contesto lungo misura la lettura e la scrittura quando 32.768 token sono già in memoria, cioè una cinquantina di pagine. La tabella confronta l'ATOM con il Ryzen AI Max+ 395 sui due modelli gpt-oss, con due build per l'ATOM. Per quanto ne sappiamo, non esiste una misurazione pubblicata nello stesso formato per il Mac.
| Modello | Macchina e stack | Lettura a 32 768 | Scrittura a 32 768 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM, build 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM, build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM, build 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM, build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395, ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395, Vulkan | 555,7 | 61,1 |
Con gpt-oss 120B, l'ATOM legge 1 832 token al secondo con 32 768 token di contesto: 2,8 volte più veloce del Ryzen AI Max+ 395 in ROCm (653) e 6 volte più veloce che in Vulkan (308). Con la build 7941, più vecchia di quella del Ryzen, il vantaggio resta di 2,4 volte e di 5 volte. Con gpt-oss 20B e la build 11430, il vantaggio è di 2,9 e 6,0 volte.
In scrittura a 32.768 token, l'ATOM (42,2 tok/s su gpt-oss 120B) è al livello della migliore stack del Ryzen (43,0 con Vulkan) e davanti all'altra (36,3 con ROCm). Il risultato è quindi semplice: su un documento lungo, la macchina AMD scrive altrettanto velocemente con la sua stack migliore (43,0 con Vulkan), ma impiega da 2,8 a 6 volte più tempo a leggerlo.
Nell'uso reale, con llama-server (il server di llama.cpp), il nostro ATOM legge un documento di 30 000 token in 21,8 secondi con gpt-oss 120B, poi scrive la risposta a 42,8 token al secondo (misurazione della nostra prima guida della serie).
#E con più utenti?
Quando più persone, o più agenti (programmi di IA che lavorano in autonomia), interrogano la macchina contemporaneamente, un server come vLLM raggruppa le loro richieste e legge i pesi del modello una sola volta per tutte le richieste. La larghezza di banda smette allora di essere l'unico freno: subentra la potenza di calcolo del GB10.
Nella nostra prima guida, gpt-oss 120B passa da 35,6 tok/s per una persona a 160,3 tok/s in totale per 16 persone, ognuna delle quali riceve ancora 10,2 tok/s. gpt-oss 20B passa da 49,1 a 322,4 tok/s in totale, con 20,7 tok/s per persona (vLLM 26.09, 6 ottobre 2026).
La tenuta nel tempo conta quanto il picco. Per 1 h con 16 utenti (richieste da 4 096 token, risposte da 512), gpt-oss 120B è rimasto a 124,8 token al secondo in totale dall'inizio alla fine: da 122,6 a 128,1 nei 14 intervalli di misurazione, cioè una deriva dello 0,0 %, con una GPU a 77 °C al massimo e nessun throttling.
Per 2 h con 8 utenti su Llama 3.3 70B in NVFP4 (un formato compresso di NVIDIA), il throughput totale è passato da 38,7 a 38,5 token al secondo (−0,6 %).
StorageReview ha misurato un carico dello stesso tipo con vLLM sulla macchina AMD Ryzen AI Halo, della famiglia Ryzen AI Max, contro un DGX Spark. La macchina AMD è rimasta indietro da 2 a 4 volte nella maggior parte degli scenari ad alta concorrenza, e fino a 8,8 volte in un test con lettura intensiva con gpt-oss 120B. Il DGX Spark condivide il chip dell'ATOM; questi dati sul Ryzen provengono dal test di StorageReview.
#Cosa cambia CUDA, in particolare per l'addestramento?
CUDA è la piattaforma software di NVIDIA per il calcolo sulle sue GPU. Sull'ATOM, con DGX OS 7.5.0 (CUDA 13.0, driver 580.159.03), llama.cpp compilato per il chip, vLLM nel container fornito da NVIDIA e Unsloth hanno funzionato nei nostri test. Per quanto ne sappiamo, molti strumenti di IA vengono scritti prima per CUDA: è un vantaggio per servire modelli e per addestrarli.
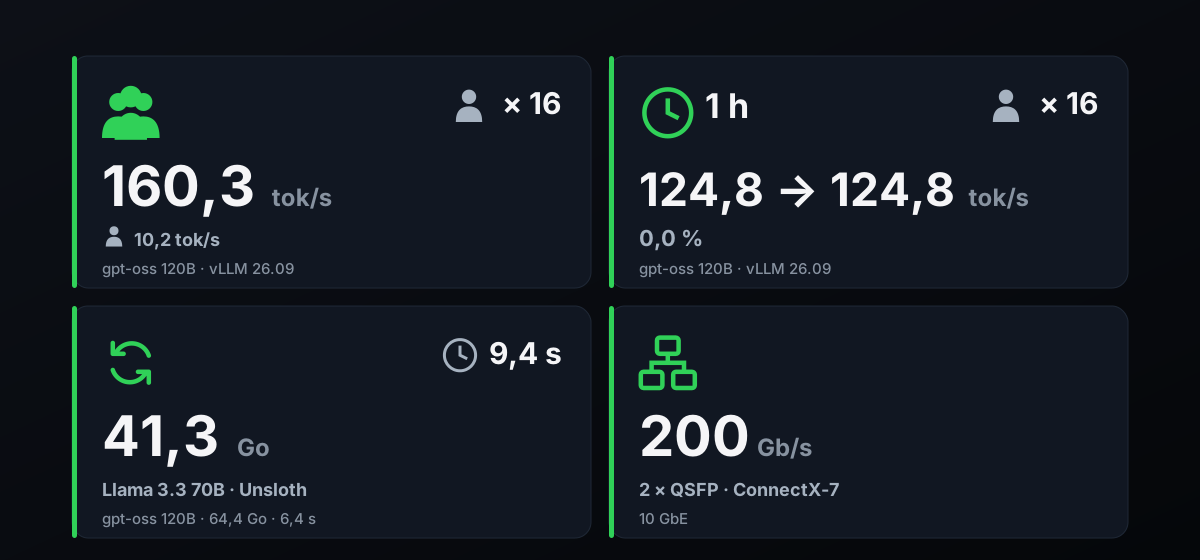
Per l'addestramento, NVIDIA dichiara il fine-tuning di modelli fino a 70 miliardi di parametri sulla piattaforma. Abbiamo misurato due casi con Unsloth 2026.10.1 e il metodo QLoRA (un fine-tuning con pesi compressi a 4 bit), sequenze da 1 024 token, 40 step di cui i primi 10 servono da riscaldamento.
Llama 3.3 70B richiede 41,3 GB di memoria GPU al picco e 9,4 secondi per step. gpt-oss 120B richiede 64,4 GB e 6,4 secondi per step. Due modelli di queste dimensioni si addestrano quindi nella memoria dell'ATOM, con margine.
Un caso concreto: un fine-tuning leggero di tipo LoRA, di 85 minuti, su Qwen3-8B (un'epoca, 2 000 esempi) ha portato la quota di fatture estratte senza alcun errore dal 26,0 % al 95,0 %, su 200 documenti mai visti e con una valutazione rigorosa. È meglio di gpt-oss 120B senza addestramento (62,5 %). Le fatture sono fittizie, generate da noi. La guida della nostra serie dedicata al fine-tuning descrive il metodo nel dettaglio.
Due porte QSFP (la scheda di rete ConnectX-7, 200 Gb/s secondo GIGABYTE) e una porta 10 GbE completano la macchina. Secondo GIGABYTE, fino a quattro macchine GB10 possono essere collegate in cluster; non abbiamo testato questa configurazione.
#Quanto costano queste tre macchine?
Prezzi IVA inclusa rilevati l'8 ottobre 2026 in Francia, sulle pagine dei rivenditori. I prezzi GB10 cambiano ogni settimana: verificali prima di acquistare.
| Macchina | Configurazione | Prezzo IVA inclusa | Marchand |
|---|---|---|---|
| GMKtec EVO-X2 (Ryzen AI Max+ 395) | 128 GB, SSD 2 TB | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX (Ryzen AI Max+ 395) | 128 GB, SSD 2 TB | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB, SSD 4 TB PCIe 4.0 | 6.346,27 € (esaurita l'8 ottobre) | negozio ufficiale AORUS (disponibile su Amazon.fr) |
| MSI EdgeXpert (GB10) | 128 GB, SSD 4 TB | 6 599,95 € (esaurito l'8 ottobre) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB, SSD 4 TB PCIe 5.0 | 7.999,95 € (non disponibile l'8 ottobre) | LDLC, Materiel.net |
| Mac Studio M5 Max (18 core CPU, 40 core GPU) | 128 GB, SSD 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max (18 core CPU, 40 core GPU) | 128 GB, SSD 4 TB | 7 839 € (calcolato) | apple.com/fr, opzioni di archiviazione |
Il Ryzen AI Max+ 395 è la macchina più economica. A parità di storage da 4 TB, l'ATOM 9000 (SSD PCIe 5.0, la versione che abbiamo misurato) e un Mac Studio M5 Max sono nella stessa fascia. L'ATOM 9001, con un SSD PCIe 4.0, è la macchina GB10 da 128 GB più economica della tabella; per quanto ne sappiamo, mantiene lo stesso chip e la stessa memoria.
L'SSD incide soprattutto sul tempo di caricamento di un modello, non sulla sua velocità di calcolo; le rilevazioni sull'SSD riguardano la versione 9000. Indichiamo anche il prezzo di un Mac Studio M5 Max, perché usa lo stesso chip delle macchine misurate nelle pubblicazioni; la sua velocità non è stata misurata in questa guida.
Le due ATOM si distinguono per lo chassis da un litro (1,2 kg) e per le scelte di GIGABYTE: raffreddamento, finitura, modelli.
#Cosa non dice questo confronto
- Origine delle misurazioni
- I dati del Ryzen AI Max+ 395 (un Framework Desktop da 128 GB) e del Mac M5 Max provengono da pubblicazioni, con relativa build e data; i mini-PC della tabella prezzi non sono stati misurati. Considera le differenze inferiori al 10 % come una parità: le build cambiano e due unità dello stesso modello differiscono di qualche punto percentuale.
- Il motore MLX di Apple non è misurato
- Su Mac, MLX può dare velocità diverse da llama.cpp o Ollama. La nostra guida MLX contro llama.cpp spiega nel dettaglio questa differenza.
- Un solo modello in comune con il Mac
- Il formato llama-bench pubblicato per l'M5 Max copre solo llama 7B. Per i modelli grandi abbiamo solo la misurazione Ollama di un lettore.
- La qualità delle risposte
- Questa guida confronta velocità, non la qualità dei modelli.
- Più utenti e addestramento sulle altre macchine
- Non li abbiamo misurati né su Ryzen né su Mac. Per il Ryzen citiamo StorageReview.
Aggiornamenti e correzioni: questa pagina sarà rivista se una nuova build di llama.cpp o una nuova pubblicazione cambierà questi risultati; ogni correzione sarà datata.
#Per chi l'ATOM è la scelta giusta
Quanto segue deriva dalle nostre misurazioni sull'ATOM e dai dati pubblicati citati sopra.
- L'ATOM è la scelta giusta se leggi documenti lunghi o codice
- Legge gpt-oss 120B 2,8 volte più velocemente del Ryzen AI Max+ 395 con 32 768 token in memoria, e un documento da 30 000 token in 21,8 secondi.
- … se più persone o agenti condividono la macchina
- 160,3 token al secondo in totale per 16 utenti con gpt-oss 120B; con richieste più lunghe, il throughput è rimasto a 124,8 token al secondo per 1 ora, senza cali.
- … se addestri o adatti dei modelli
- Un QLoRA su 70 miliardi di parametri sta in 41,3 GB. Un LoRA su fatture ha richiesto 85 minuti.
- … se vuoi grandi modelli MoE in un case da un litro
- gpt-oss 120B scrive 58,8 token al secondo su una macchina da 1,2 kg.
- Un Mac M5 Max è più adatto se scrivi da solo con piccoli modelli densi
- Scrive circa due volte più velocemente su llama 7B (119,9 contro 59,4 token al secondo).
- Un mini-PC Ryzen AI Max+ 395 è più adatto se decide il budget
- La scrittura resta vicina sui modelli MoE, a partire da 3 449,99 €, ma la lettura è da 2,1 a 2,8 volte più lenta.
In sintesi: se il tuo lavoro consiste nel leggere testi lunghi, l'ATOM è la scelta giusta secondo i nostri confronti. Per servire più persone o addestrare, le sue misurazioni sono solide: 160,3 token al secondo in totale per 16 utenti, un QLoRA da 70 miliardi di parametri in 41,3 GB. Se scrivi da solo con piccoli modelli densi, guarda il Mac. Se decide il budget, guarda il Ryzen.
#FAQ
Qual è la macchina più veloce tra il GB10, il Ryzen AI Max+ 395 e il Mac M5 Max?+
L'AI TOP ATOM è più veloce di un Mac M5 Max?+
Perché i numeri di una stessa macchina cambiano da un sito all'altro?+
Come posso confrontare la mia macchina con questi numeri?+
Il Ryzen AI Max+ 395 è una buona scelta rispetto al GB10?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.