GIGABYTE AI TOP ATOM: la GB10 da 128 GB misurata nel dettaglio
Il mini-PC IA di GIGABYTE: chip NVIDIA GB10 e 128 GB di memoria unificata in un litro. Vediamo cosa conta per eseguire LLM in locale : memoria, banda passante, velocità, prezzo — e per chi è (o non è) l'acquisto giusto.
Aggiornato l'08/10/2026
Scheda tecnica
- Memoria128 GB unificati (LPDDR5x), 121,7 GB visibili dal sistema
- Larghezza di banda273 GB/s
- CalcoloGPU Blackwell e 20 core Arm; fino a 1 PFLOP in FP4 con sparsità secondo NVIDIA (annuncio, non misurato da noi)
- ConsumoAdattatore USB-C da 240 W; GPU a 10,4 W a riposo e da 39 a 53 W in media sotto carico nelle nostre rilevazioni (solo GPU, senza wattmetro)
- Prezzo indicativo6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, negozio ufficiale AORUS, esaurita; disponibile su Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC e Materiel.net, non disponibile) — rilevazione dell'08/10/2026
- Modello più grandeQwen3-235B-A22B a 3 bit (90,5 GB occupati, 21 GB di margine) · Llama 3.3 70B a circa 5 token al secondo, da 2,6 a 4 volte più veloce con un piccolo modello ausiliario (draft) · gpt-oss 120B a 58 token al secondo; i nostri 13 modelli, dal 4B al 235B, entrano con 32 768 token di contesto
Per chi?
Vantaggi e limiti
✓ Punti di forza
- 128 GB di memoria unificata: i nostri 13 modelli, dal 4B al 235B (a 3 bit), entrano con 32 768 token di contesto
- Le velocità del DGX Spark di NVIDIA, con uno scarto massimo del 4,3% con llama.cpp e del 2% con Ollama
- Velocità stabile sotto carico continuo: 0,0% di deriva in 1 h con 16 utenti, −0,6% in 2 h con 8 utenti, nessuna limitazione segnalata
- SSD da 4 TB PCIe 5.0 sull'ATAGB10-9000: 13 GB/s in lettura
- Stack CUDA completo: llama.cpp, vLLM, TensorRT-LLM e Unsloth hanno funzionato da noi
- Telaio da un litro, 1,2 kg, pannello frontale essenziale
✗ Limiti
- Prezzo superiore a quello di un mini-PC Ryzen AI Max+ 395 da 128 GB
- Un modello denso da 70B scrive a circa 5 token al secondo, limite della larghezza di banda della piattaforma GB10 (273 GB/s): un modello MoE o un piccolo modello ausiliario (draft) (×2,6–×4) offre velocità di conversazione
Cosa abbiamo misurato
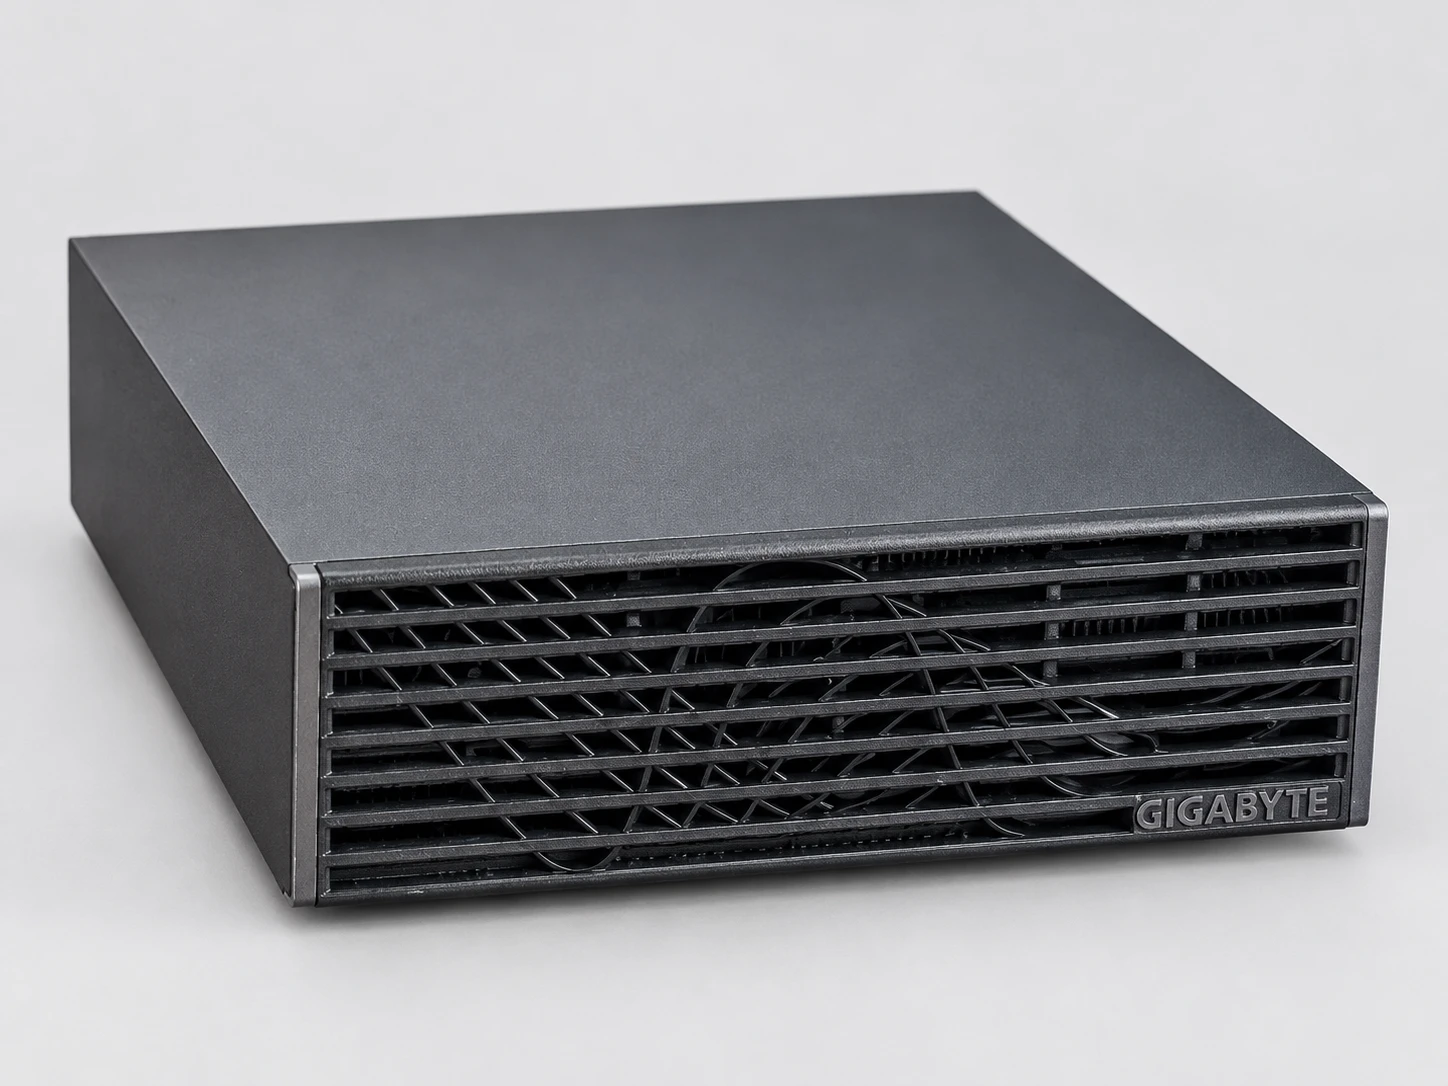
GIGABYTE ci ha fornito gratuitamente una AI TOP ATOM (ATAGB10-9000: 128 GB, SSD da 4 TB PCIe 5.0) per una serie di guide. Le misurazioni e le opinioni sono nostre; GIGABYTE non ha né revisionato né approvato questo contenuto prima della pubblicazione. Il metodo (protocollo fissato prima della prima misurazione), le impronte dei file dei modelli e i dati delle nostre tabelle sono pubblicati nella nostra pagina del metodo. I nostri dati, infografiche e foto sono riutilizzabili con licenza CC BY 4.0, citando quelllm.fr.
| Guide | Cosa mostra |
|---|---|
| Quali LLM funzionano davvero | 13 modelli dal 4B al 235B: entrano tutti con 32 768 token di contesto; gpt-oss 120B a 58 token al secondo |
La serie conta 7 guide, pubblicate una a settimana: questa pagina si arricchisce con ogni nuova guida.
I modelli AI TOP ATOM
GIGABYTE declina l'ATOM in sei modelli, da ATAGB10-9000 ad ATAGB10-9005. I primi tre hanno 128 GB: 9000 con un SSD da 4 TB in PCIe 5.0 (quello che abbiamo misurato), 9001 con 4 TB in PCIe 4.0, 9002 con 1 TB in PCIe 4.0. Una versione da 64 GB è annunciata a partire dal 23 ottobre 2026. Verifica il modello esatto presso il rivenditore: alcune schede descrivono male l'SSD.
Per chi
- Un team da 5 a 20 persone che vuole un assistente IA privato sui propri documenti (misurato fino a 10 utenti simultanei).
- Uno sviluppatore CUDA che vuole l'intero stack NVIDIA sulla propria scrivania.
- Il fine-tuning locale : LoRA di un Qwen3-8B, QLoRA di un 70B e di gpt-oss 120B con Unsloth.
- I grandi modelli MoE da oltre 100 miliardi di parametri, a una velocità confortevole.
Verdetto
Domande frequenti
La GIGABYTE AI TOP ATOM può eseguire localmente un LLM da 70B?
Qwen3-235B-A22B a 3 bit (90,5 GB occupati, 21 GB di margine) · Llama 3.3 70B a circa 5 token al secondo, da 2,6 a 4 volte più veloce con un piccolo modello ausiliario (draft) · gpt-oss 120B a 58 token al secondo; i nostri 13 modelli, dal 4B al 235B, entrano con 32 768 token di contesto.
Quanto costa la GIGABYTE AI TOP ATOM?
Mettete in conto 6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, negozio ufficiale AORUS, esaurita; disponibile su Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC e Materiel.net, non disponibile) — rilevazione dell'08/10/2026 (Versione da 64 GB annunciata da NVIDIA a partire da 4 999 $ (Stati Uniti), disponibile dal 23/10/2026; GIGABYTE ha confermato una AI TOP ATOM da 64 GB il 05/10/2026). I prezzi cambiano rapidamente: verifica il prezzo del giorno presso il rivenditore.
Per chi è pensata la GIGABYTE AI TOP ATOM?
Sviluppatori CUDA, team che vogliono un assistente IA privato, fine-tuning locale, grandi modelli MoE da oltre 100B.