GB10 128 GB: quali LLM funzionano davvero (misurazioni)
Su una GIGABYTE AI TOP ATOM (NVIDIA GB10, 128 GB), i 13 modelli misurati, dal 4B al 235B, ci stanno con 32 768 token di contesto e almeno 20 GB di margine. I grandi modelli MoE, che attivano soltanto una parte dei loro parametri a ogni token, sono molto più veloci di un modello denso delle stesse dimensioni: gpt-oss 120B scrive 58 token al secondo. Un 70B denso scrive a 4,8 token al secondo: è la larghezza di banda della memoria, non lo spazio disponibile, a determinare la velocità.
Centoventotto gigabyte di memoria unificata: è il vantaggio delle macchine GB10 rispetto alle schede grafiche. Ma cosa si può davvero caricare, con quale margine e a quale velocità? Abbiamo misurato 13 modelli, dal 4B al 235B, su una AI TOP ATOM fornita gratuitamente da GIGABYTE, con un protocollo fissato prima della prima misurazione. Ecco cosa riesce a gestire, cosa è piacevole nell'uso quotidiano e per chi è l'acquisto giusto.
Stai scegliendo un computer? Le nostre scelte per budget → · La nostra scheda NVIDIA DGX Spark →
Buon rapporto qualità/prezzo per l'IA locale: un GMKtec EVO-X2 64 GB / 1 TB (Ryzen AI Max+ 395).
Un mini-PC è una macchina completa: verifica la memoria disponibile e la compatibilità del motore. Non sostituisce macOS/MLX o CUDA.
Perché questa scelta? La nostra scheda completa su GMKtec EVO-X2 64 GB / 1 TB (Ryzen AI Max+ 395) →
Confronta tutte le opzioni per budget, da 800 a 3 500 € →
Budget ridotto: RTX 5060 · Modelli grandi: RTX 5090 · Mac Studio.
In mobilità: quale portatile per l'IA locale →
Link affiliati — possibile commissione senza costi aggiuntivi per te. In qualità di Partner Amazon, QuelLLM ottiene un guadagno dagli acquisti che soddisfano i requisiti.
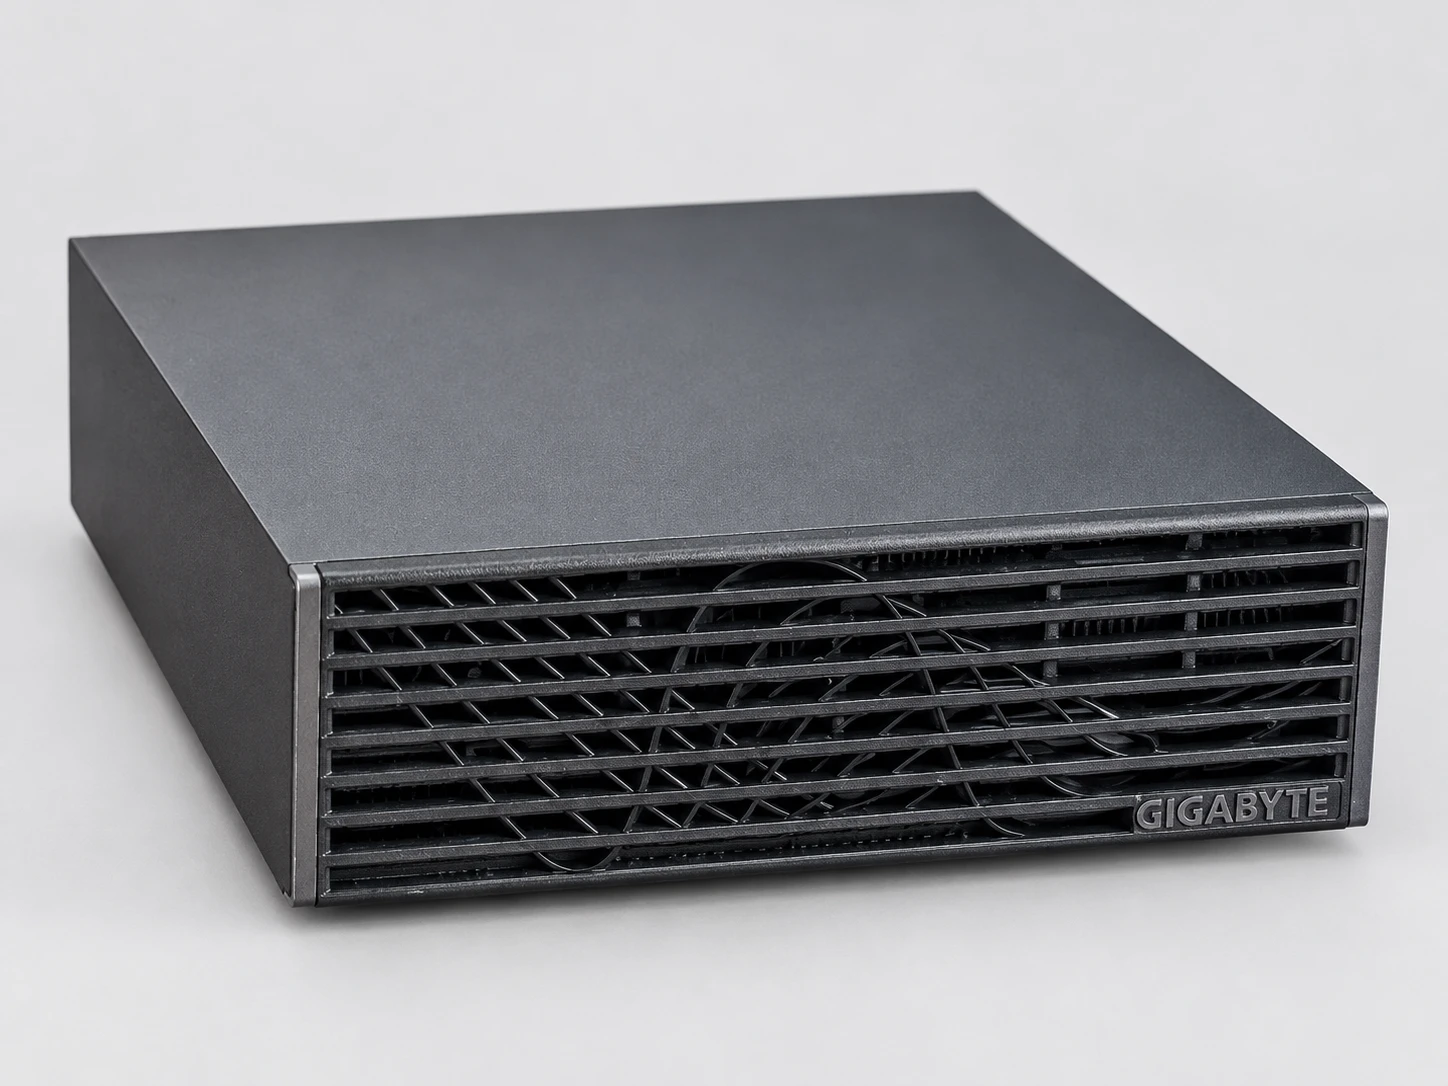
#La macchina testata
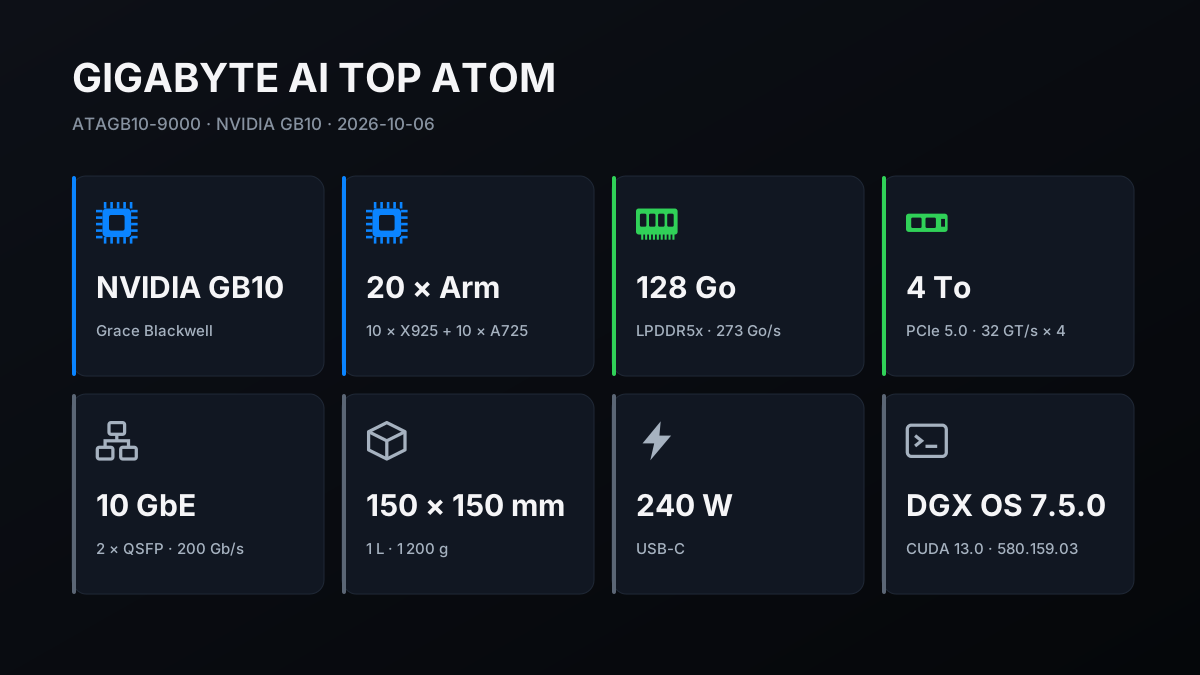
La macchina è una GIGABYTE AI TOP ATOM, modello ATAGB10-9000: chip NVIDIA GB10 (20 core Arm e una GPU Blackwell che condividono 128 GB di memoria dichiarata a 273 GB/s), SSD da 4 TB su PCIe 5.0. Funziona con DGX OS 7.5.0, il sistema di NVIDIA basato su Ubuntu (driver 580.159.03, CUDA 13.0).
Sono stati utilizzati tre software. llama.cpp, un motore open source molto diffuso per eseguire i modelli in locale, compilato sul posto per il chip GB10, fornisce la tabella principale. Ollama 0.34.1 serve per il confronto con un MacBook Pro M5 Max misurato con la stessa versione. vLLM 26.09, un server progettato per rispondere a più persone contemporaneamente, gira nel contenitore fornito da NVIDIA.
#Come abbiamo effettuato le misurazioni
Le velocità di llama.cpp provengono da cinque ripetizioni, con una deviazione standard (la dispersione tra le ripetizioni) non superiore al 3%. I tempi di caricamento, la lettura di un documento da 30 000 token e i margini di memoria sono misurazioni singole; i test con più utenti sono ripetuti tre volte. Prima della prima misurazione, un test di tre minuti ha verificato che la GPU mantenesse la propria potenza di calcolo.
I file dei 13 modelli hanno un'impronta SHA-256 (una firma digitale del file) identica a quella pubblicata da Hugging Face, il sito che ospita questi modelli. Il protocollo, redatto il 5 ottobre, è stato congelato il 6 alle 13:30, prima della prima misurazione.
Un'appendice dello stesso giorno, intorno alle 16 h 50, ha anticipato alla sera la nuova misurazione a freddo e aggiunto i test ripresi qui: script ufficiale diOllama, decodifica speculativa, carico continuo e Llama 3.3 70B in NVFP4. Il metodo, le impronte dei file e i dati delle nostre tabelle sono pubblicati nella nostra pagina sul metodo.
I dati principali sono stati rimisurati a freddo la sera stessa, dopo 20 minuti di riposo e con la cache svuotata: al massimo il 2,6% di scarto, al di sotto della soglia del 3% prevista dal protocollo.
#La stessa velocità di un DGX Spark, con pochi punti percentuali di differenza
Per quanto ne sappiamo, le macchine GB10 da 128 GB condividono lo stesso chip NVIDIA e la stessa memoria; la loro costruzione, il raffreddamento e lo spazio di archiviazione possono differire. Per collocare l'ATOM, abbiamo ripetuto due riferimenti pubblicati per il DGX Spark di NVIDIA, con la stessa versione del software e le stesse impostazioni.
Con llama.cpp (build 7941, quello della tabella pubblicata dal progetto; la nostra tabella principale usa il build 11430, più recente), su sei modelli comuni, la lettura è identica entro il 2,3%; la scrittura è inferiore del 2,8% in mediana e del 4,3% al massimo. Con lo script ufficiale diOllama (versione 0.12.6, quella delle sue misurazioni pubblicate), le nostre tre misurazioni sono entro il 2%, sia in lettura sia in scrittura: gpt-oss 20B, gpt-oss 120B e Llama 3.1 70B.
Le velocità di questa guida dovrebbero quindi valere, con uno scarto di pochi punti percentuali, per le altre macchine GB10 da 128 GB; abbiamo misurato solo l'ATOM. La sua costruzione e il suo comportamento sotto carico (temperature, stabilità dopo 1 h e 2 h) sono descritti in dettaglio nella guida successiva della serie, mentre i consumi sono trattati in una guida dedicata.
#13 modelli, dal 4B al 235B: spazio occupato e velocità
La tabella riassume la campagna. « Memoria occupata » è la riduzione della memoria disponibile una volta caricato il modello con 32 768 token di contesto riservati. « Caricamento » è il tempo di caricamento a freddo, con la cache del disco svuotata. Le velocità provengono dallo strumento di misurazione llama-bench (llama.cpp, build 11430 del 5 ottobre 2026), prima con contesto vuoto e poi con 32 768 token già presenti; le durate effettive per un documento lungo sono riportate più avanti.
| Modello | Tipo | Memoria occupata | Chargement | Scrittura (vuoto → 32k) | Lettura (vuoto → 32k) | Uso |
|---|---|---|---|---|---|---|
| Gemma 3 4B (Q4_0) | dense | 4,6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | molto fluido |
| Qwen2.5-Coder 7B (Q8_0) | dense | 10,2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE, 3,6 Md attivi | 13,0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | molto fluido |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE, 3 mld attivi | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | molto fluido |
| GLM-4.7-Flash (Q8_0) | MoE, 3 mld attivi | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | molto fluido |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE, 3,3 mld attivi | 34,3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | molto fluido |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | ideale per l'elaborazione in batch |
| gpt-oss 120B (MXFP4) | MoE, 5,1 Md attivi | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | molto fluido |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE, 10 mld attivi | 74,5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE, 12 mld attivi | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B (IQ4_XS) | MoE, circa 6 Md attivi | 89,5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE, 22 mld attivi | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | adeguato; compressione forte (Q2) |
Per leggere la tabella: un modello denso fa lavorare tutti i suoi parametri a ogni token, un modello MoE (« mixture of experts ») soltanto una frazione, indicata in miliardi (Md). La sigla tra parentesi indica la compressione dei pesi. Nei nostri file, Q8 occupa 8,5 bit per parametro, i formati Q4 e MXFP4 da 4,3 a 5,6 bit, e Q2_K_XL 3 bit: è la compressione più forte della tabella.
La colonna «Uso» applica i nostri riferimenti alla velocità di scrittura con contesto vuoto: molto fluida oltre 40 token al secondo, fluida da 20 a 40, adeguata da 10 a 20. Al di sotto, riserviamo il modello ai processamenti batch.
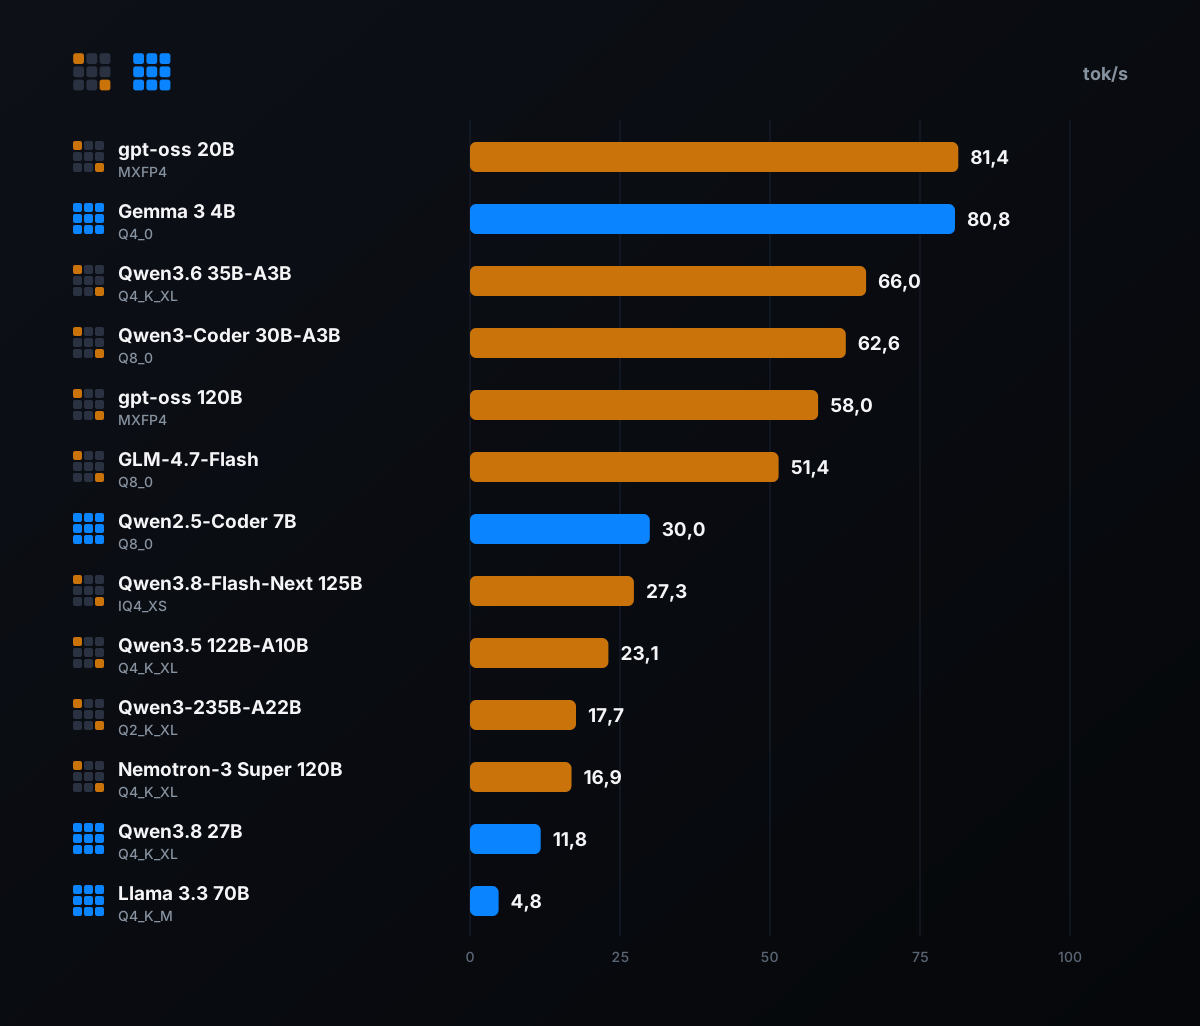
Primo insegnamento: nulla in questa tabella mette in difficoltà la macchina; persino Qwen3-235B lascia 21 GB liberi con 30 000 token di contesto. Secondo insegnamento, più utile per scegliere: lo spazio non è quasi mai un limite; è la scelta del modello a determinare la velocità, da 4,8 a 81,4 token al secondo.
#Ciò che determina la velocità: i parametri attivi, non la dimensione
Per scrivere ogni token, il chip deve rileggere in memoria i pesi che servono a quel token. Con 273 GB/s di banda passante, la velocità massima si calcola semplicemente: 273 diviso il volume dei pesi letti per ogni token. Un modello denso legge tutti i suoi pesi ogni volta; un modello MoE ne legge solo una frazione, gli «esperti» scelti per quel token.
È questo che spiega il paradosso della tabella. Il file di gpt-oss 120B pesa 59 GB, ma il modello attiva solo 5,1 miliardi di parametri per token: scrive a 58,0 token al secondo. Qwen3.8 27B, il cui file è più di tre volte più leggero (16 GB), è un modello denso: attiva tutti i suoi 27 miliardi di parametri a ogni token e scrive a 11,8 token al secondo. Il modello grande è quasi cinque volte più veloce di quello piccolo.
| Modello | Parametri attivi | Limite teorico | Misurato | Quota del limite massimo |
|---|---|---|---|---|
| Qwen2.5-Coder 7B (denso) | 7,6 Md | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B (denso) | 70,6 Md | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B (denso) | 27,3 mld | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 mld | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5,1 mld | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B (MoE) | 3 Md | 141,1 | 66,0 | 47 % |
La tabella considera sei modelli, quelli il cui numero di parametri attivi è pubblicato o rilevato da llama.cpp. I modelli densi raggiungono dal 74 all'89% di questo limite: il GB10 sfrutta quasi tutta la sua memoria.
Sull'insieme dei tredici modelli, gli otto MoE escluso Qwen3.8-Flash-Next raggiungono dal 47 all'81%, sei di loro tra il 52 e il 62%; la scelta degli esperti e i calcoli accessori aggiungono probabilmente un tempo fisso a ogni token. Qwen3.8-Flash-Next non rientra in questo calcolo: conta 51 miliardi di parametri di tabella di consultazione oltre ai suoi 125 miliardi, il che rende inadatta la stima.
A parità di dimensioni, tuttavia, i MoE restano molto più veloci. Da qui il nostro consiglio principale: su una macchina GB10, per un modello grande, privilegiate un MoE. Anche un piccolo modello denso come Gemma 3 4B scrive molto velocemente (80,8 token al secondo), ma è molto più piccolo e serve ad altri usi.
- MoE spiegato: perché un 30B-A3B gira come un modello piccolo
- Scegliere la quantizzazione (Q4, Q5, Q8, FP16)
#I modelli con più di 100 miliardi di parametri
È questa la ragione d'essere dei 128 GB. NVIDIA annuncia per la piattaforma modelli fino a 200 miliardi di parametri; le nostre misurazioni confermano questa promessa, e un 235B compresso a 3 bit ci sta persino oltre. Cinque modelli con più di 100 miliardi di parametri stanno sull'ATOM, tutti con almeno 20 GB di margine a 30 000 token di contesto.
- gpt-oss 120B, il miglior compromesso tra velocità e spazio
- 58,0 token al secondo, 61,7 GB occupati con il suo contesto, caricato in 10 secondi. OpenAI lo pubblica direttamente in formato MXFP4: ci sta senza ulteriore compressione.
- Qwen3.8-Flash-Next 125B, il più veloce dei Qwen giganti
- 27,3 token al secondo con circa 6 miliardi di parametri attivi, 89,5 GB occupati in IQ4_XS. Anche la sua versione Q4_K_XL, meno compressa, entra, con un margine ridotto (vedi più avanti).
- Qwen3.5 122B-A10B
- 23,1 token al secondo, 74,5 GB; i suoi dieci miliardi di parametri attivi lo collocano dietro a gpt-oss.
- Nemotron-3 Super 120B-A12B (NVIDIA)
- 16,9 token al secondo, 80,4 GB. Con dodici miliardi di parametri attivi, scrive più lentamente di gpt-oss ed è il modello la cui scrittura regge meglio quando il contesto si allunga: da 16,5 a 32 768 token, circa il 3% in meno.
- Qwen3-235B-A22B, a parte
- Ci sta in Q2_K_XL, la compressione più forte della tabella (3 bit per parametro in media): 17,7 token al secondo, 90,5 GB. Una compressione così forte riduce in genere la qualità delle risposte; non l'abbiamo misurata.
#Dove si ferma la memoria: intorno ai 100–105 GB di pesi
Il sistema vede 121,7 GB di memoria: una parte dei 128 viene riservata già all'avvio. Una volta avviata la macchina, senza nient'altro in memoria, restavano disponibili da 108 a 113 GB a seconda del momento. Per trovare il limite, abbiamo caricato due versioni più pesanti dei modelli più grandi, con lo stesso contesto di 32 768 token e un meccanismo di sicurezza che interrompe il caricamento se la memoria libera scende sotto i 3 GB.
| Modello | File | Memoria occupata | Margine residuo | Scrittura (dopo la lettura di 4 000 → 30 000 token) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 GB | 107,0 GB | 6,0 GB | 24,9 → 21,9 tok/s | Al limite |
| Qwen3-235B-A22B (Q3_K_XL, 3,5 bit) | 97,0 GB | 104,7 GB | 8,2 GB | 13,9 → 10,4 tok/s | Al limite |
Nessun modello ha fallito il caricamento, ma questi due lasciano un margine ridotto: c'è appena spazio per un secondo modello, un contesto molto più lungo o un'applicazione esigente affiancata. Il limite pratico si colloca quindi intorno ai 100–105 GB di pesi. Esclude, per esempio, i pesi NVFP4 (un formato compresso di NVIDIA) di Qwen3.8-Flash-Next: circa 135 GB secondo il blog Kubesimplify (27 agosto 2026), che precisa che in tal caso servono due macchine.
Questo stesso articolo mostrava già il modello su una sola macchina in GGUF (il formato di llama.cpp), ma allora esisteva soltanto la versione più compressa. Sull'ATOM funzionano le versioni IQ4_XS e Q4_K_XL, con 21 e 6 GB di margine.
#Il prezzo del contesto lungo
Un documento lungo, una base di codice o una conversazione che si prolunga: ogni token già presente nel contesto rallenta il seguito. Con 32 768 token in memoria, la velocità di scrittura diminuisce dal 3 al 47% a seconda dei modelli. Abbiamo anche misurato il tempo reale necessario per leggere in un unico blocco un documento di 30 000 token, una cinquantina di pagine.
| Modello | Lettura di 30 000 token | Scrittura successiva |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 tok/s |
| gpt-oss 120B | 21,8 s | 42,8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 tok/s |
| Qwen3-235B-A22B | 1 min 33 s | 12,1 tok/s |
| Llama 3.3 70B | 1 min 44 s | 4,0 tok/s |
Per la maggior parte dei modelli, questi tempi sono più lunghi di quanto suggerisca la colonna «Lettura» della prima tabella. Il motivo probabile: llama-server, il server utilizzato nella pratica, elabora per impostazione predefinita il testo in batch da 512 token, contro i 2 048 della nostra configurazione di llama-bench.
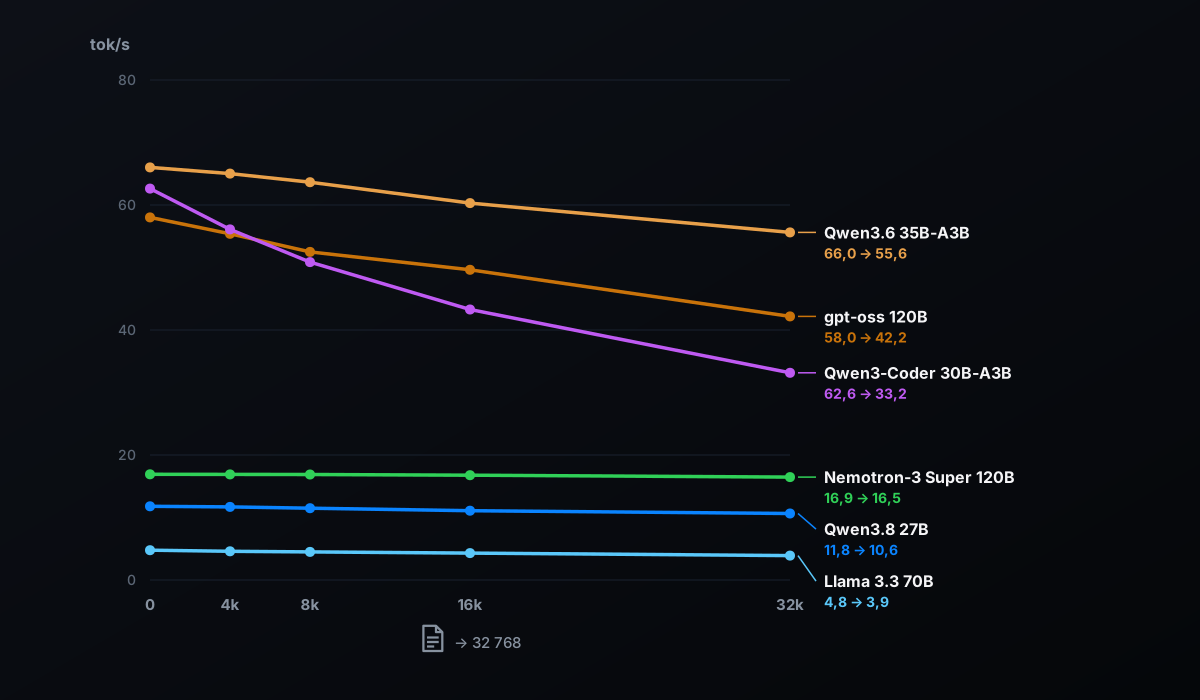
La lettura è un punto di forza della GB10: rispetto al Mac confrontato più avanti, legge gpt-oss 120B il 31% più velocemente. Se si deposita un rapporto di una cinquantina di pagine, la risposta inizia 22 secondi dopo con gpt-oss 120B, e 1 min 44 s dopo con un 70B denso. Per l'analisi dei documenti e gli agenti di codice, questo criterio pesa molto.
#Fino a 16 utenti contemporaneamente: cosa riesce a gestire la macchina
Con vLLM abbiamo simulato 1, 8 e poi 16 utenti simultanei. Ognuno invia una richiesta di 1 024 token e riceve una risposta di 512 token; ogni punto è misurato tre volte con richieste diverse e pubblichiamo la mediana.
| Modello | Utenti | Total | Per persona | Prima parola (media) | Prima parola (casi più lenti) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 tok/s | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14,5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 tok/s | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
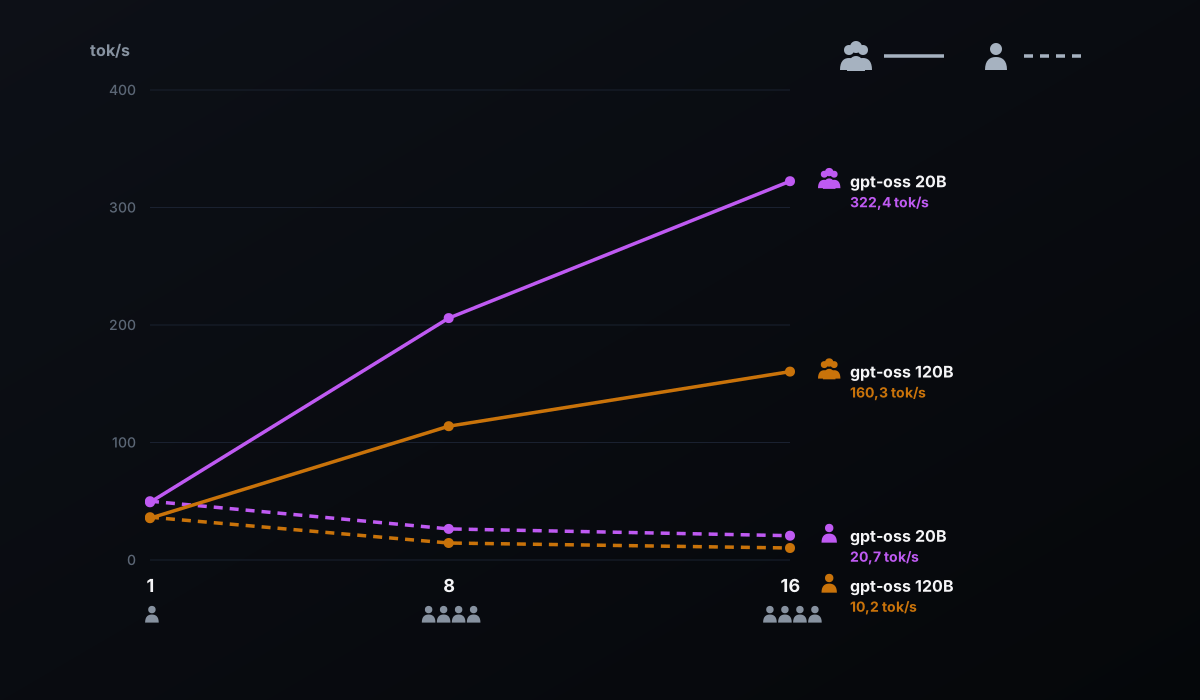
Tra 1 e 16 utenti, il throughput totale viene moltiplicato per 4,5 con gpt-oss 120B e per 6,6 con gpt-oss 20B: quando più richieste condividono la lettura degli stessi pesi, il chip sfrutta appieno la sua potenza di calcolo.
Con 16 persone, ciascuna vede ancora la propria risposta scriversi a 10 token al secondo con gpt-oss 120B, e a 21 con gpt-oss 20B. Con il modello da 120 miliardi, la prima parola arriva in media in poco più di un secondo, e in quasi 4 secondi nei casi più lenti.
Per una sola persona, invece, vLLM non è il più veloce: senza particolari regolazioni delle prestazioni, scrive a 36,4 token al secondo su gpt-oss 120B, contro i 54,4 di llama.cpp sulle risposte lunghe. I suoi log mostrano che sul GB10 sceglie il kernel di calcolo Marlin per il formato MXFP4, cosa che probabilmente spiega lo scarto. vLLM si giustifica non appena più persone o più agenti condividono la macchina.
#Da solo davanti alla macchina: Ollama o llama.cpp?
Ollama è il modo più semplice per iniziare e funziona sul GB10 senza regolazioni. Su gpt-oss, tuttavia, non è il più veloce. Sulle risposte lunghe, la versione 0.34.1 scrive a 42,3 token al secondo su gpt-oss 120B, contro i 54,4 di llama.cpp nello stesso formato MXFP4, ovvero il 22% in meno. Su gpt-oss 20B: 58,8 contro 78,8, ovvero il 25% in meno.
Sui modelli Qwen, è il contrario. Su Qwen3.8 27B, Ollama scrive tra 22,9 e 30,5 token al secondo a seconda del passaggio, contro gli 11,8 di llama.cpp con le impostazioni predefinite; su Qwen3.6 35B-A3B, tra 90,5 e 94,9, contro 66,0. Il motivo probabile: Ollama attiva per impostazione predefinita una decodifica speculativa, che propone diversi token in anticipo e che il modello convalida in una volta sola (l'impostazione draft_num_predict compare nella configurazione di questi modelli).
Il nostro test va nella stessa direzione. Su llama-server (sei testi da 400 token, prosa e codice), la decodifica speculativa di llama.cpp (MTP, che prevede più token alla volta) porta Qwen3.8 27B da 11,7 a 21,5 token al secondo in prosa, e da 11,6 a 27,2 nel codice.
In pratica: Ollama per iniziare e per i modelli Qwen, che accelera automaticamente; llama.cpp per ottenere il massimo da gpt-oss, oppure da Qwen3.8 attivando la sua decodifica speculativa. La scelta migliore dipende dalle impostazioni più che dalla macchina.
#A confronto con il MacBook Pro M5 Max da 128 GB
Un lettore ha misurato il suo MacBook Pro M5 Max da 128 GB (GPU da 40 core) il 16 settembre con Ollama 0.34.1, in un solo passaggio per modello; le sue rilevazioni sono pubblicate nella nostra guida dedicata. Abbiamo ripetuto le stesse serie sull'ATOM, in due passaggi: stessa versione di Ollama, stessi modelli, stesso prompt.
| Misurazione | ATOM, 1° passaggio | ATOM, 2º passaggio | MacBook Pro M5 Max | Scarto |
|---|---|---|---|---|
| Scrittura, gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7–+27 % |
| Scrittura, qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 a +59 % |
| Scrittura, gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93–+95 % |
| Scrittura, gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87% |
| Lettura, gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
Il Mac scrive più velocemente su tutti e quattro i modelli, quasi il doppio sui due gpt-oss, i cui passaggi concordano: il suo chip dispone di 614 GB/s di banda passante, più del doppio rispetto al GB10. Su gemma4 e qwen3.8, lo scarto varia da un passaggio all'altro; la decodifica speculativa, il cui guadagno dipende dal testo generato, è una possibile spiegazione.
L'ATOM legge più velocemente, probabilmente grazie alla potenza di calcolo della sua GPU, su testi simili ma non identici (16 850 e 16 689 token). Con llama.cpp, la differenza nella scrittura si riduce: 54,4 token al secondo su gpt-oss 120B, contro 79,1 per il Mac con Ollama.
#Per chi l'ATOM è la scelta giusta
Quanto segue deriva dalle nostre misurazioni sull'ATOM.
- L'ATOM è la scelta giusta se vuoi modelli di grandi dimensioni a casa tua
- Cinque modelli con più di 100 miliardi di parametri ci stanno comodamente. Per quanto ne sappiamo, nessuna scheda grafica consumer si avvicina a questi 128 GB.
- … se lavori su documenti lunghi o codice
- 30 000 token letti in 22 secondi con gpt-oss 120B.
- … se la condividono più persone o agenti
- 160 token al secondo complessivi per 16 utenti su gpt-oss 120B.
- … se volete l'ecosistema NVIDIA
- CUDA 13, vLLM nel contenitore di NVIDIA e llama.cpp compilato per il chip GB10 hanno funzionato da noi con DGX OS 7.5.0.
- Se siete da soli e puntate innanzitutto sulla velocità di scrittura
- Confronta con il MacBook Pro M5 Max: grazie ai suoi 614 GB/s, scrive più velocemente su gpt-oss, mentre l'ATOM legge un documento lungo il 31% più velocemente su gpt-oss 120B. Confronta anche i prezzi.
- Se i vostri modelli restano sotto i 35 GB
- La versione da 64 GB dell'ATOM, annunciata per il 23 ottobre 2026, dovrebbe essere sufficiente (calcolo ricavato dalle nostre misurazioni, non misurato su questa versione).
- Quale LLM su Mac Studio (da M2 a M4 Ultra, da 64 a 512 GB)?
- Ryzen AI Max+ 395 (Strix Halo): 128 GB di memoria per LLM locali
- Quale LLM per 32 GB di VRAM?
#64 o 128 GB?
Il 2 ottobre 2026, NVIDIA ha annunciato DGX Spark da 64 GB per modelli fino a 100 miliardi di parametri, disponibili il 23 ottobre presso Acer, ASUS, Dell, GIGABYTE, HP e MSI, a partire da 4 999 dollari. Il 5 ottobre GIGABYTE ha confermato una AI TOP ATOM 64 GB con lo stesso design. Non l'abbiamo misurata.
Le nostre misurazioni permettono un calcolo. I modelli fino a Qwen3-Coder 30B-A3B occupano meno di 35 GB con 32 768 token di contesto e ci starebbero; Llama 3.3 70B (51 GB) sarebbe al limite. gpt-oss 120B (62 GB) e i modelli più grandi non ci starebbero. A parità di larghezza di banda, cosa che bisognerà verificare, le velocità dovrebbero essere simili.
Per un modello con più di 100 miliardi di parametri su una sola macchina, la versione da 128 GB è la scelta obbligata. Secondo NVIDIA, anche due macchine da 64 GB collegate mettono in comune la memoria; non lo abbiamo testato.
#I prezzi rilevati
L'8 ottobre 2026, la versione da 4 TB in PCIe 4.0 (ATAGB10-9001, stesso chip GB10 e gli stessi 128 GB) era indicata a 6 346,27 € IVA inclusa sul negozio ufficiale AORUS, esaurita; era disponibile su Amazon.fr, venduta da Amazon UK (un esemplare). La versione testata, da 4 TB in PCIe 5.0 (ATAGB10-9000), costava 7 999,95 € da LDLC e Materiel.net, non disponibile.
Prezzi e disponibilità di queste macchine cambiano rapidamente: verificatele prima di acquistare.
#Il nostro giudizio
L'ATOM è un'ottima scelta per eseguire a casa un modello da 120 miliardi di parametri, condividerlo con un team o leggere rapidamente documenti lunghi. Ci ha fornito le prestazioni di riferimento della piattaforma, senza limitazioni termiche rilevate nelle nostre misurazioni, anche durante un'ora di carico continuo con 16 utenti. Se il budget è importante, la versione PCIe 4.0 mantiene lo stesso chip e la stessa memoria.
#Ciò che non abbiamo misurato
- La qualità delle risposte
- Questa guida misura ciò che riesce a gestire e a quale velocità, non il valore di ogni modello.
- Le temperature, il rumore e i consumi
- La prossima guida della serie illustra in dettaglio le temperature sotto carico prolungato; il consumo ha una guida dedicata, misurato sul chip (solo GPU). Per il rumore, citiamo le misurazioni di Hardware & Co.
- I contesti oltre 32 768 token
- Diversi modelli accettano contesti molto più lunghi; questa guida si ferma a 32 768 token, e il tutorial 70B della serie arriva fino a 131 072 token per Llama 3.3 70B e gpt-oss 120B.
- Le altre macchine GB10 e la versione da 64 GB
- I nostri numeri sono in linea con quelli pubblicati per il DGX Spark di NVIDIA, ma abbiamo misurato soltanto l'ATOM 128 GB.
Aggiornamenti e correzioni: questa pagina sarà rivista se una nuova versione di DGX OS, di llama.cpp o di Ollama modifica questi risultati; ogni correzione sarà datata.
- I dati delle nostre misurazioni, tabella per tabella (CSV)
- Il nostro metodo di misurazione e le sue appendici datate
- NVIDIA, caratteristiche della piattaforma DGX Spark (GB10, 273 GB/s, modelli fino a 200 miliardi di parametri)
- Llama.cpp, tabella di riferimento pubblicata per il DGX Spark (build 7941)
- Ollama, misurazioni pubblicate per il DGX Spark (23 ottobre 2025)
- OpenAI, scheda di gpt-oss 120B (5,1 miliardi di parametri attivi, formato MXFP4)
- Kubesimplify, Qwen3.8-Flash-Next su DGX Spark (27 agosto 2026)
- NVIDIA, annuncio del DGX Spark 64 GB (2 ottobre 2026)
- GIGABYTE, annuncio dell'AI TOP ATOM da 64 GB (5 ottobre 2026)
- Apple, caratteristiche del MacBook Pro M5 Max (614 GB/s)
- Rilevazione dei prezzi dell'8 ottobre 2026: negozio ufficiale AORUS (ATAGB10-9001)
- Rilevazione dei prezzi dell'8 ottobre 2026: LDLC (ATAGB10-9000)
- Rilevazione dei prezzi dell'8 ottobre 2026: Amazon.fr (ATAGB10-9001)
- Rilevazione dei prezzi dell'8 ottobre 2026: Materiel.net (ATAGB10-9000)
#FAQ
Qual è il modello più grande che si può far funzionare su una macchina GB10 da 128 GB?+
Un modello 70B è utilizzabile quotidianamente su una GB10?+
Le velocità di questa guida valgono per un DGX Spark di NVIDIA o per un'altra marca?+
Meglio scegliere la versione da 64 GB o da 128 GB?+
Ollama è la scelta migliore su una macchina GB10?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.