LLM 70B in locale su GB10: il tutorial complet
Su un GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), Llama 3.3 70B ci sta con margine: 43,6 GB con un contesto di 8.192 token, 82 GB con 131.072. Scrive tra 4,6 e 5,3 token al secondo con tre soluzioni: Ollama, llama.cpp o vLLM. Una bozza Llama 3.2 1B porta llama.cpp a 12 token al secondo in prosa e 19 nel codice. Con otto utenti, vLLM mantiene in media 38,6 token al secondo in totale per due ore.
Un modello da 70 miliardi di parametri come Llama 3.3 70B è «denso»: usa tutti i suoi parametri per scrivere ogni parola e richiede molta memoria. I 128 GB di una macchina GB10 lo ospitano ampiamente. Questo tutorial fornisce i comandi per tre modi di installarlo, testati su un'AI TOP ATOM fornita gratuitamente da GIGABYTE, e poi le misurazioni che aiutano a scegliere: velocità, piccolo modello draft, memoria del contesto, tenuta su due ore e servizio a più utenti.
#La macchina, il metodo e le unità
Prima, un po' di vocabolario. Un token è un pezzo di parola: in francese, un token equivale a circa due terzi di parola. Il contesto è il testo che il modello tiene in memoria durante uno scambio: le tue domande, i tuoi documenti e le sue risposte. La velocità di scrittura è il ritmo con cui viene visualizzata la risposta, in token al secondo (tok/s). La velocità di lettura è il ritmo con cui la macchina assimila il tuo testo prima di rispondere.
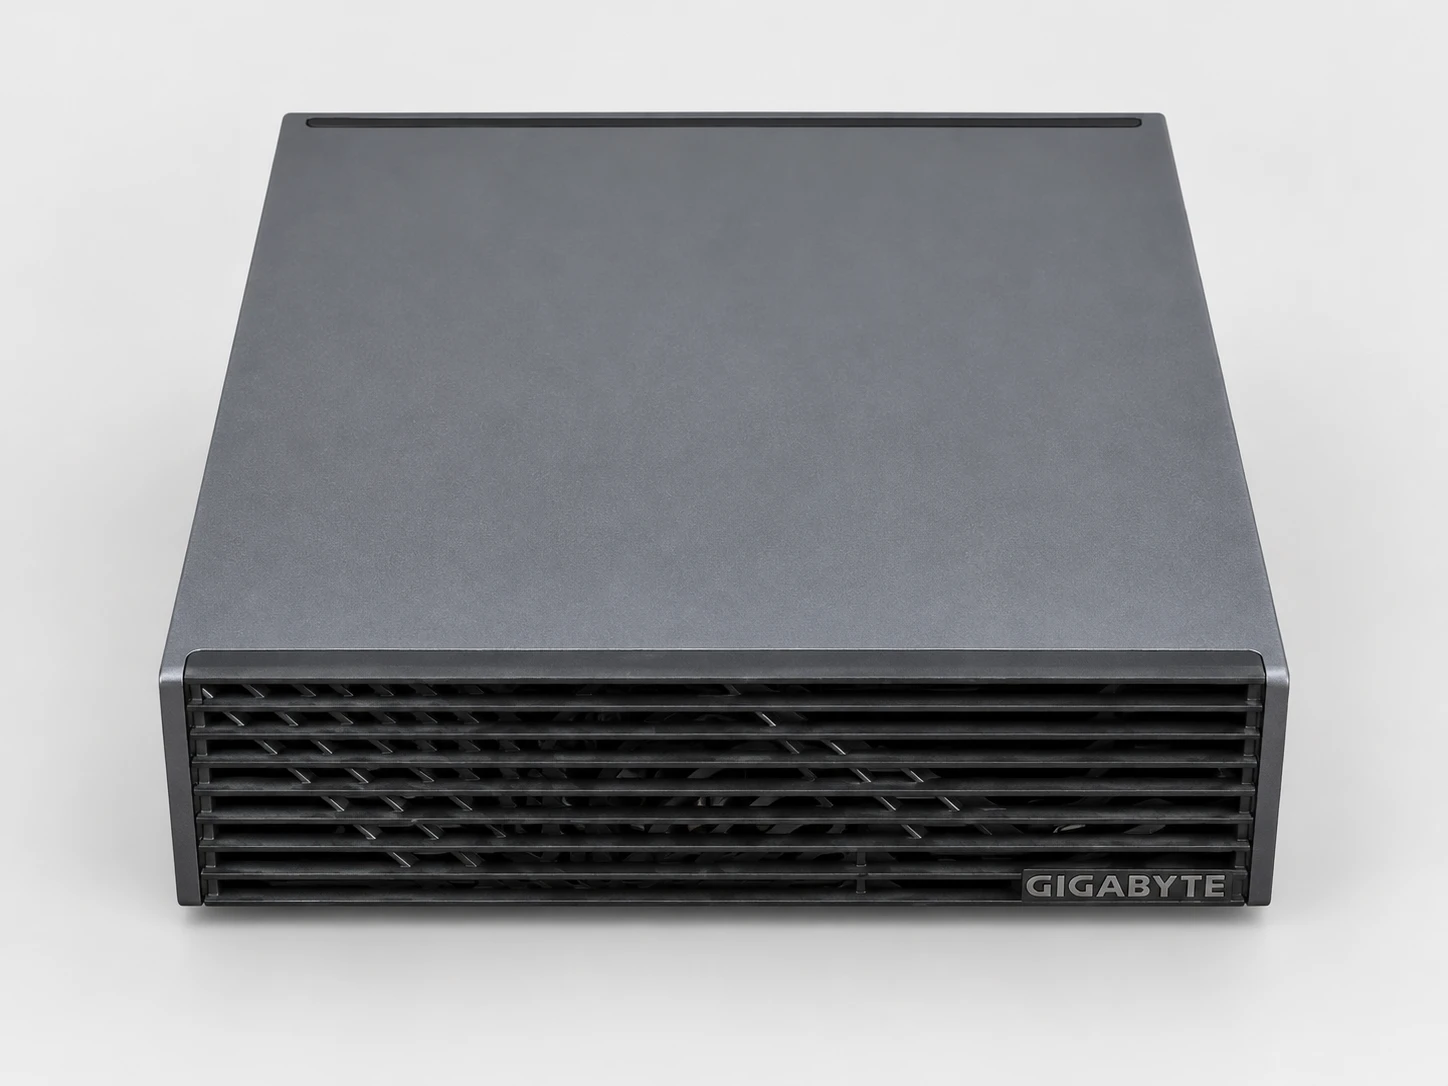
La macchina è una GIGABYTE AI TOP ATOM, modello ATAGB10-9000. Il suo chip NVIDIA GB10 riunisce 20 core Arm e una GPU Blackwell, che condividono 128 GB di memoria a 273 GB/s. L'SSD è da 4 TB PCIe 5.0. Gira su DGX OS 7.5.0, il sistema di NVIDIA basato su Ubuntu (driver 580.159.03, CUDA 13.0). Il sistema vede 121,7 GB di memoria.
- Cosa deriva dalla piattaforma NVIDIA GB10
- Il chip, i suoi 128 GB a 273 GB/s e DGX OS determinano le velocità di questa guida. Riproducendo due benchmark di riferimento pubblicati per il DGX Spark di NVIDIA, con llama.cpp e con Ollama, le nostre velocità si discostano al massimo del 4,3%. Per quanto ne sappiamo, dovrebbero quindi valere anche per le altre macchine GB10 da 128 GB. Le misurazioni di questa guida sono state effettuate sull'AI TOP ATOM.
- Cosa arriva da GIGABYTE
- Lo chassis da circa un litro e il suo raffreddamento, le finiture, le configurazioni (la 9000 monta un SSD da 4 TB PCIe 5.0) e la garanzia del rivenditore. Durante le nostre due ore di servizio continuo, la GPU non ha superato i 72 °C e non si è verificato alcun throttling.
Le misurazioni risalgono al 6 e 7 ottobre 2026 (per l'assistente privato con Open WebUI, al 7 e 8 ottobre). Il protocollo è stato congelato il 6 ottobre alle 13:30, prima della prima misurazione. Alcune integrazioni datate, scritte prima delle prove che descrivono, hanno aggiunto la decodifica speculativa e il budget di memoria. Il metodo e i dati delle nostre tabelle sono pubblicati nella nostra pagina sul metodo.
Le velocità di scrittura di llama.cpp e TensorRT-LLM provengono da sei testi da 400 token: tre in prosa francese e tre richieste di codice. Quelle di Ollama (un testo di 300 parole) e di vLLM (richieste casuali da 1 024 token in input e 256 in output) seguono i protocolli descritti nelle rispettive sezioni. La temperatura è fissata a 0: il modello sceglie sempre la parola più probabile, il che rende le prove confrontabili. Pubblichiamo la mediana dei tre testi di ciascun tipo.
Le dimensioni della memoria sono in GB (1 GB = 1 024 MB, come mostrato da Linux); le velocità di trasferimento in GB/s sono quelle dichiarate dai produttori, in unità decimali. Le versioni utilizzate sono llama.cpp b11430 (build del 5 ottobre 2026), Ollama 0.34.1, vLLM 26.09 e TensorRT-LLM 1.3.0rc12, questi ultimi due nei container di NVIDIA. La nostra prima guida della serie riporta le misurazioni di 13 modelli, tra cui Llama 3.3 70B; questa mostra come installarlo e accelerarlo.
#Via 1: Ollama, la più semplice
Ollama è il modo più semplice per iniziare: un archivio da decomprimere, un comando per scaricare il modello, un altro per parlarci. Abbiamo installato la versione 0.34.1 dall'archivio ufficiale per Linux Arm, in una cartella e senza servizio di sistema. Se preferisci l'installer abituale, la nostra guida all'installazione su Linux lo descrive.
L'opzione --verbose fa mostrare le statistiche alla fine della risposta. Da noi, Llama 3.3 70B (in Q4_K_M, una compressione dei pesi) scrive a 4,97 tok/s al primo passaggio e a 4,95 tok/s al secondo. Il comando ollama ps indica 85 GB caricati, in unità decimali: Ollama ha aperto di sua iniziativa un contesto di 131 072 token. Su un testo di 18 823 token, la lettura richiede 55,6 s, ovvero 338,7 tok/s, e la scrittura che segue resta a 4,38 tok/s.
Per inquadrare questi numeri: Ollama pubblica 4,423 tok/s per Llama 3.1 70B Q4_K_M su un DGX Spark di NVIDIA (versione 0.12.6, 23 ottobre 2025). Con la stessa versione, lo stesso script e lo stesso modello (Llama 3.1 70B), il nostro ATOM dà 4,34 tok/s, entro il 2 %. Per ridurre il contesto e la memoria occupata, imposta la variabile OLLAMA_CONTEXT_LENGTH prima di avviare il server; non abbiamo misurato questa variante.
#Via 2: llama.cpp, quella che offre più impostazioni
llama.cpp è un motore open source molto diffuso. Legge i modelli in formato GGUF, un unico file che contiene i pesi. Va compilato una volta per il chip GB10, ma dà accesso a tutte le impostazioni: dimensione del contesto, formato della cache del contesto, modello bozza. La compilazione segue la guida di NVIDIA, con l'architettura CUDA 121a-real, quella del GB10, ma senza libcurl (-DLLAMA_CURL=OFF) né RPC.
Il file scelto è Llama 3.3 70B in Q4_K_M, pubblicato da bartowski: 39,6 GB. Con la cache del disco svuotata, llama.cpp lo carica in 8 s dall'SSD. Il comando hf proviene dalla libreria huggingface_hub (installazione: pip install -U huggingface_hub). Se Hugging Face ti chiede di accettare la licenza Llama, accettala sul sito, poi accedi con hf auth login.
- -ngl 99
- Carica tutti i layer del modello sulla GPU.
- -fa on
- Attiva Flash Attention, che rende più efficiente la lettura del contesto.
- -lm dio
- Legge il file con accesso diretto al disco, senza passare dalla cache del sistema (mmap). È la modalità della tabella di riferimento pubblicata dal progetto llama.cpp per il DGX Spark.
- -c 16384 -np 1
- Un contesto di 16 384 token per un solo utente. Il contesto richiesto è condiviso tra gli utenti simultanei.
- --host 127.0.0.1
- Il server è raggiungibile solo dalla macchina stessa.
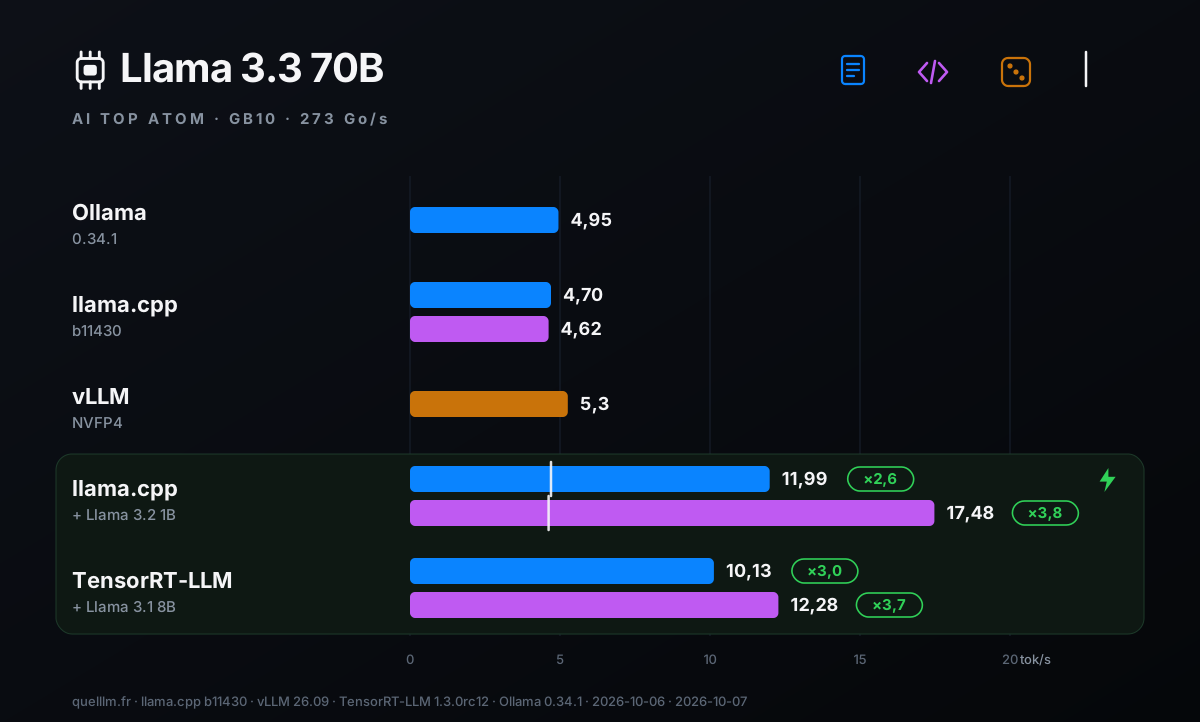
Sui nostri sei testi, llama-server scrive a 4,70 tok/s in prosa e 4,62 in codice. Lo strumento di misura llama-bench dà 4,8 tok/s in scrittura (32 token) e 405 tok/s in lettura (2 048 token). Il modello occupa 43,6 GB con un contesto di 8 192 token.
Come riferimento, la memoria legge al massimo 273 miliardi di byte al secondo, e ogni token richiede di rileggere i pesi del modello, cioè 42,5 miliardi di byte: il massimo teorico è di 6,4 tok/s, e la misura ne raggiunge circa i tre quarti.
#Via 3: vLLM in NVFP4, per più utenti
vLLM è un server progettato per rispondere a più persone contemporaneamente. NVIDIA lo fornisce in un container, cioè un programma isolato avviato da Docker. Il modello è Llama 3.3 70B in NVFP4, un formato a 4 bit di NVIDIA che i chip Blackwell calcolano direttamente: occupa 39,9 GB di memoria. La matrice dei modelli supportati nella guida vLLM di NVIDIA per DGX Spark elenca questo modello.
Le impostazioni --max-model-len 8192 e --max-num-seqs 16 limitano il contesto a 8 192 token e a 16 richieste elaborate contemporaneamente. L'impostazione --gpu-memory-utilization 0.85 stabilisce la quota di memoria che vLLM riserva: qui 103 GB, di cui 59,6 GB di cache. Questa cache mantiene contemporaneamente 390 352 token, ovvero l'equivalente di quasi 48 richieste da 8 192 token alla volta. Il primo avvio richiede circa 7 minuti: 4 min 20 s per leggere il modello, poi circa 2 minuti di preparazione.
Con un utente, vLLM scrive a 5,3 tok/s (5,26, 5,27 e 5,26 su tre serie) e la prima parola arriva in 0,73 s in media. Con otto utenti simultanei, la macchina scrive 37,7 tok/s in totale, attesa della prima parola compresa; una volta iniziata la sua risposta, ogni utente riceve 5,0 tok/s.
La prima parola arriva in 2,8 s in media e in meno di 4,8 s nei casi più lenti. Le richieste di questo test hanno 1 024 token in ingresso e 256 in uscita; ogni punto è misurato tre volte.
#Le tre vie fianco a fianco
| Via | Scrittura | Memoria | Impostazioni | Da scegliere per |
|---|---|---|---|---|
| Ollama 0.34.1 (Q4_K_M) | 4,95 | 85 GB indicati da Ollama (in unità decimali, cioè circa 79 GB nel senso di questa guida) con il contesto di 131 072 token che apre senza alcuna impostazione | peu | iniziare in fretta |
| llama.cpp b11430 (Q4_K_M) | 4,70 in prosa, 4,62 nel codice | 43,6 GB a 8 192 token, 51,3 GB a 32 768 | tutti: contesto, cache, draft | un utente, con una bozza |
| vLLM 26.09 (NVFP4) | 5,3; 37,7 in totale per 8 utenti | 103 GB riservati con l'impostazione 0,85 | quelli di un server | più utenti |
Le tre modalità generano testo alla stessa velocità, con uno scarto inferiore al 15%. Il motivo è semplice: per ogni token il chip rilegge i pesi del modello, ed è la larghezza di banda di 273 GB/s a dettare il ritmo di un modello denso. Un 70B scrive quindi a circa 5 tok/s, cioè circa 200 parole al minuto, il ritmo di una lettura pacata.
Questo ritmo va bene per le elaborazioni che possono attendere: riassunti, estrazioni, revisioni, bozze di risposte. Per una conversazione fluida esistono due leve, presentate nelle sezioni seguenti: il modello bozza e un modello MoE (mixture of experts) che usa solo una parte dei suoi parametri a ogni token.
#Accelerare un 70B con un piccolo modello bozza
La decodifica speculativa usa un piccolo modello, la bozza, che propone più parole in anticipo (più esattamente token; diciamo «parole» per semplicità). Il modello grande verifica queste parole in un solo passaggio: costa più o meno il tempo necessario a scriverne una sola, perché il tempo è soprattutto quello della lettura dei pesi.
Le parole giuste vengono mantenute, le altre vengono scartate. La bozza non sceglie il testo: è sempre il modello grande a convalidare. NVIDIA descrive il principio nella sua guida per DGX Spark, e il blog LMSYS osserva che questa tecnica attenua in parte il limite di larghezza di banda della macchina.
#Con llama.cpp: una bozza Llama 3.2 1B
La bozza deve parlare la stessa lingua del modello grande, cioè usare la stessa suddivisione in token. La famiglia Llama va bene: Llama 3.2 1B, in Q8_0, accompagna Llama 3.3 70B. Bastano quattro opzioni: -md indica la bozza, --spec-type draft-simple sceglie il metodo, --spec-draft-n-max fissa il numero di token proposti in anticipo (in questa guida li chiamiamo «parole») e -ngld 99 carica la bozza sulla GPU.
| Configurazione | Prosa in francese | Codice | Accettazione (prosa / codice) |
|---|---|---|---|
| Solo il 70B | 4,70 | 4,62 | — |
| + bozza Llama 3.2 1B, 8 parole di anticipo | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + bozza Llama 3.2 1B, 16 parole di anticipo | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
La bozza da 1 miliardo di parametri rende il 70B da 2,6 a 4 volte più veloce: 12 tok/s in prosa e fino a 19 tok/s nel codice. Il guadagno dipende dal testo. Su tre testi di codice, la velocità va da 13,2 a 18,0 tok/s con 8 parole in anticipo. La bozza viene seguita più spesso sul codice (50 % di parole mantenute) che sulla prosa (33 %).
I nostri testi sono in francese per la prosa e in inglese per il codice; altri testi daranno altri guadagni. Per la prosa, 8 parole in anticipo rendono meglio di 16 (11,99 contro 10,84). Per il codice, 16 rendono un po' di più (18,65 contro 17,48), con uno scarto tra testi dello stesso ordine. Inizia con 8.
Lo stesso principio esiste senza un secondo file quando il modello integra un proprio modulo di predizione multi-token (MTP). Con Qwen3.8 27B e l'opzione --spec-type draft-mtp, llama.cpp passa da 11,71 a 21,48 tok/s in prosa (×1,8) e da 11,59 a 27,23 tok/s nel codice (×2,3).
#Con TensorRT-LLM: la ricetta Draft-Target di NVIDIA
TensorRT-LLM è la libreria di NVIDIA per servire i modelli in modo ottimizzato. La sua guida per DGX Spark propone il metodo Draft-Target: Llama 3.3 70B in FP4 è affiancato da Llama 3.1 8B in FP4 come bozza. Entrambi i modelli sono forniti da NVIDIA. Nella versione 1.3.0rc12 del container, il valore dell'impostazione si scrive Draft_Target, con il trattino basso.
| Configurazione | Prosa in francese | Codice |
|---|---|---|
| + draft Llama 3.1 8B FP4, 4 parole di anticipo | 10,13 (×3,0 rispetto allo stesso motore senza bozza) | 12,28 (×3,7) |
Con TensorRT-LLM, il modello bozza moltiplica la velocità per 3,0 in prosa e per 3,7 nel codice, rispetto allo stesso motore senza bozza: il 70B scrive così 10,1 token al secondo in prosa e 12,3 nel codice.
Le due vie, llama.cpp e TensorRT-LLM, offrono quindi un guadagno dello stesso ordine, da 2,6 a 4 volte. Per un solo utente, llama.cpp resta la più semplice: un file draft e quattro opzioni. TensorRT-LLM è la via da seguire se vuoi la ricetta ufficiale di NVIDIA, con modelli FP4 forniti da NVIDIA.
#Il budget di memoria del contesto, da 8 192 a 131 072 token
Il contesto ha un costo in memoria: la cache KV. È la memoria in cui il modello conserva ciò che ha già letto, per non ricalcolarlo. Cresce con la lunghezza del contesto. llama.cpp riserva tutta questa cache fin dal caricamento, quindi la memoria occupata dopo il caricamento è già quella finale.
La misuriamo in base al calo della memoria disponibile (MemAvailable di Linux), dopo aver svuotato la cache del disco. L'opzione -ctk q8_0 -ctv q8_0 memorizza la cache a 8 bit invece che a 16 (f16), rendendola più leggera. Nelle tabelle e nei grafici, 8k indica un contesto di 8.192 token, 32k di 32.768, 64k di 65.536 e 128k di 131.072.
| Modello | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
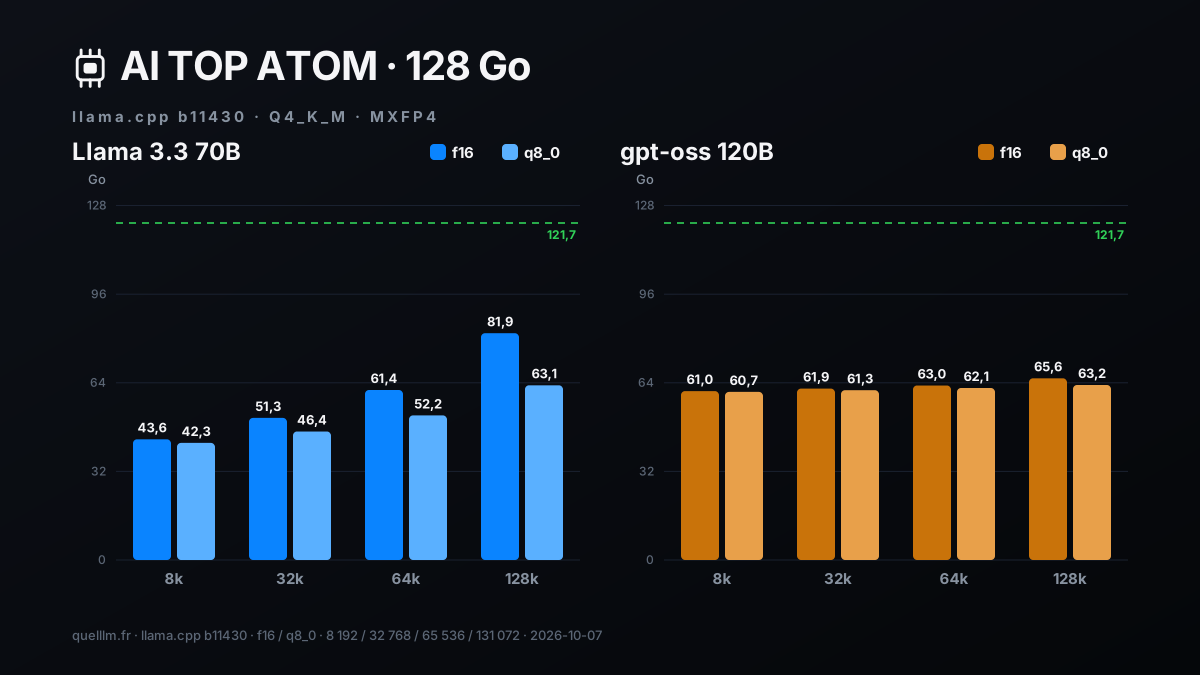
Tutto sta nei 121,7 GB, anche il 70B con un contesto di 131 072 token in f16: 81,9 GB. Tra 8k e 128k il contesto aggiunge al 70B 38 GB in f16 e 21 GB in q8_0, cioè quasi la metà. gpt-oss 120B aggiunge solo 4,6 GB: alterna livelli che guardano tutto il testo e livelli che ne guardano solo una finestra breve. Il formato q8_0 si paga con una velocità un po' più bassa, dal 9 all'11 % a 128k per il 70B (tabella seguente).
Abbiamo anche riempito il contesto al 90 % con schede pratiche di Service-Public, per misurare lettura e scrittura a contesto pieno. A 128k il testo è di 117 605 token per il 70B e di 117 889 per gpt-oss 120B, cioè circa 200 pagine.
| Modello | Cache | Testo letto (token) | Memoria (GB) | Lecture | Scrittura |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
Tutto funziona a contesto pieno. gpt-oss 120B legge un testo di 200 pagine in 110 secondi e continua a scrivere a quasi 27 tok/s. Il 70B legge i 117.605 token a 182 tok/s. Per documenti molto lunghi, un modello MoE è più veloce, sia in lettura sia in scrittura.
#Due ore di servizio con otto utenti
Un server deve reggere nel tempo. Abbiamo avviato vLLM 26.09 con Llama 3.3 70B in NVFP4 e inviato richieste per due ore: otto utenti in continuo, blocchi di 32 richieste da 1.024 token in input e 256 in output. Un monitoraggio del chip, con una misurazione al secondo, ha registrato potenza, frequenza e temperatura della GPU.
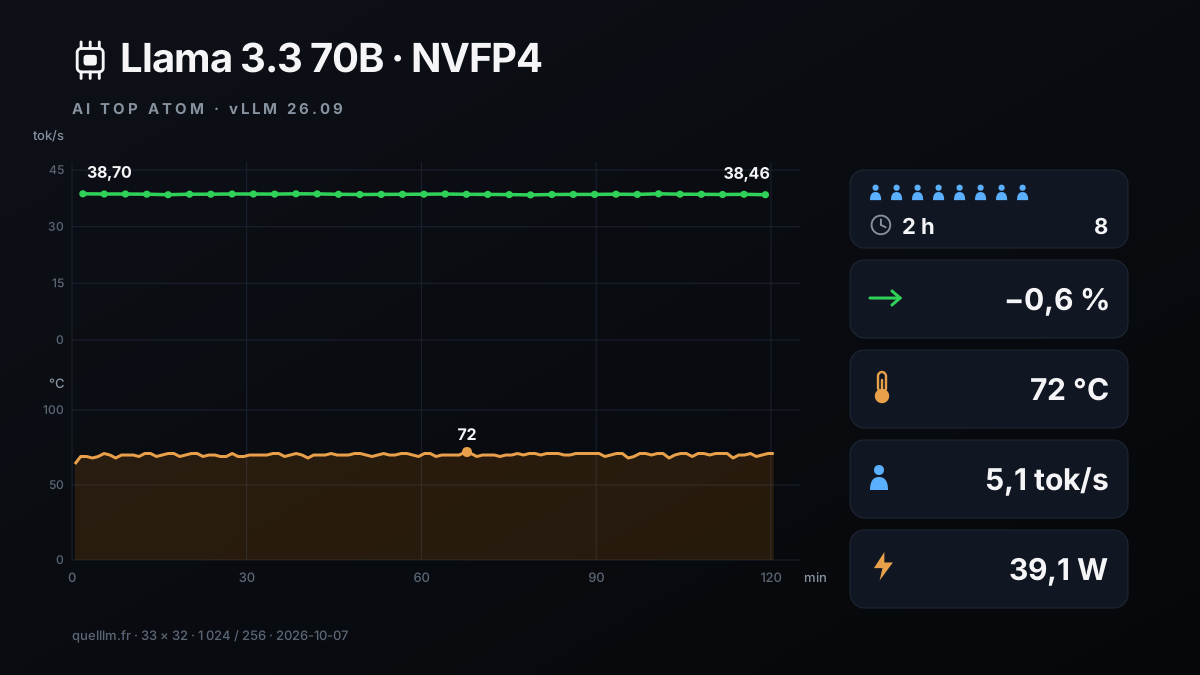
Il risultato è semplice: la velocità non è cambiata. Il throughput totale va da 38,70 tok/s nella prima fascia a 38,46 nell'ultima, con un minimo di 38,40 e un massimo di 38,70: lo scarto è del −0,6 %. Ogni utente riceve 5,1 tok/s. La prima parola arriva in 2,8 s in mediana, tra 2,4 e 2,9 s a seconda della fascia.
In totale, la macchina ha servito 1 056 richieste, letto 1 081 344 token e scritto 270 336 token, senza alcun errore. La GPU è rimasta al massimo a 72 °C. La sua frequenza mediana era di 2 528 MHz e non è stata rilevata alcuna causa di throttling durante le due ore di monitoraggio.
La potenza media della GPU è stata di 39,1 W, con un picco di 95,0 W. Questi watt sono quelli della GPU, letti dal chip: non includono né il processore, né la memoria, né l'SSD, né l'alimentatore. Le due ore corrispondono a 78,8 Wh per la GPU, cioè 1,6 centesimi alla tariffa EDF Tarif Bleu Base (6 kVA), a 20,01 centesimi al kWh.
#Trasformarlo in un server: API OpenAI, chiave e Open WebUI
Un'API OpenAI è un formato di richieste che molti strumenti sanno parlare: editor di codice, interfacce di chat, script. llama-server e vLLM la offrono entrambi. Per proteggerla, llama-server accetta una chiave con l'opzione --api-key: senza chiave, risponde con un errore 401. Abbiamo convalidato queste tre chiamate con gpt-oss 20B; per il 70B è lo stesso comando con un altro file.
La prima chiamata restituisce 401, la seconda l'elenco dei modelli serviti, la terza una risposta in formato OpenAI. L'opzione --jinja applica il template di conversazione fornito dal file del modello.
Per un'interfaccia di chat, Open WebUI si collega a questa API. Ecco lo stack del nostro test di assistente privato (un'altra guida della serie), con gpt-oss 120B. Il server del modello si trova in una rete Docker interna, senza accesso a Internet. Open WebUI 0.11.4 è collegato a questa rete e a una rete di accesso.
In questo modo il modello non ha alcuna uscita verso l'esterno. Il server non ha chiave, perché solo la rete interna può raggiungerlo; il valore local di OPENAI_API_KEY serve solo a soddisfare Open WebUI. Per servire invece il 70B, sostituisci il percorso del file con quello di Llama-3.3-70B-Instruct-Q4_K_M.gguf e adatta -c e -np al budget di memoria visto sopra.
Poi apri http://127.0.0.1:3100 in un browser della macchina: il modello compare nell'elenco. Nel nostro test dell'assistente privato, lo stack completo, con in più un server di embedding (bge-m3), era pronto in 66 secondi. Secondo la guida llama.cpp di NVIDIA, Open WebUI, Continue.dev e altri client si collegano a questa API, che segue il formato dell'API OpenAI (indirizzo del server seguito da /v1).
#L'alternativa veloce: un modello MoE da 120B
Un modello MoE (mixture of experts) contiene molti parametri ma ne usa solo una frazione a ogni token. gpt-oss 120B conta 117 miliardi di parametri, di cui 5,1 miliardi attivi, e OpenAI lo pubblica direttamente in formato MXFP4.
Sulla GB10 scrive a 58,0 tok/s con lo strumento di misura llama-bench (scrittura di 32 token) e a 54,4 tok/s nelle risposte lunghe su llama-server, sia in prosa sia in codice. È più di 11 volte la velocità del 70B denso, con una memoria occupata di 61,0 GB a 8 192 token e di 65,6 GB a 131 072.
La velocità non dice nulla sulla qualità: non abbiamo confrontato le risposte dei due modelli. Ecco come scegliere. Scegli gpt-oss 120B per la conversazione, gli agenti e i documenti lunghi, dove la velocità conta. Scegli Llama 3.3 70B se ti serve proprio questo modello, per esempio un modello ottimizzato a partire da esso, oppure per elaborazioni in batch in cui 5 tok/s bastano. Le misure dei 13 modelli, dal 4B al 235B, si trovano nella nostra prima guida della serie.
#Cosa non misura questa guida
- La qualità delle risposte
- Misuriamo la velocità e la memoria, non quanto vale ciascun modello.
- I guadagni del modello bozza su altri testi
- I nostri sei testi sono in francese per la prosa e in inglese per il codice. I guadagni dipendono dal testo e dalla lingua.
- I contesti oltre i 131 072 token
- Non abbiamo misurato né la loro memoria né la loro velocità.
- Le altre macchine GB10 e la versione da 64 GB
- Le nostre misure sull'ATOM 128 GB concordano con i riferimenti pubblicati per il DGX Spark.
- Il consumo dell'intera macchina
- I watt indicati sono quelli della GPU, letti dal chip.
Aggiornamenti e correzioni: questa pagina sarà rivista se una nuova versione di DGX OS, llama.cpp, Ollama, vLLM o TensorRT-LLM cambierà questi risultati; ogni correzione sarà datata.
#Per chi l'ATOM è la scelta giusta
Quanto segue deriva dalle nostre misure sull'ATOM, una macchina GB10 da 128 GB.
- ATOM è la scelta giusta se vuoi un modello da 70 miliardi di parametri a casa tua
- Ci sta con margine: da 43,6 a 82 GB su 121,7 GB, con un contesto da 8.192 a 131.072 token, e tutte e tre le modalità di installazione funzionano.
- … se più persone o agenti condividono il modello
- Otto utenti ottengono 37,7 tok/s in totale su una serie breve e 38,6 tok/s in media nell'arco di due ore, senza alcun errore.
- … se vuoi andare più veloce senza cambiare macchina
- Una piccola bozza moltiplica la velocità del 70B da 2,6 a 4 volte, con llama.cpp o con la ricetta di NVIDIA.
- … se vuoi una conversazione rapida o documenti lunghi
- gpt-oss 120B scrive a 54,4 tok/s e legge 200 pagine in 110 secondi.
- … se il tuo lavoro passa per l'ecosistema NVIDIA
- CUDA 13, vLLM e TensorRT-LLM nei container di NVIDIA e llama.cpp compilato per la GB10 hanno funzionato nei nostri test con DGX OS 7.5.0.
Lato GIGABYTE, lo chassis di circa un litro ha mantenuto la GPU al massimo a 72 °C durante due ore di carico continuo, senza throttling. I prezzi delle macchine GB10 cambiano ogni settimana: verificali sulla scheda della macchina prima di acquistare.
#FAQ
Si può far girare un modello 70B su una macchina GB10 da 128 GB?+
A che velocità scrive un 70B sull'AI TOP ATOM?+
Meglio scegliere Ollama, llama.cpp o vLLM?+
Come rendere più veloce un 70B senza cambiare macchina?+
Un 70B può servire più persone per ore?+
È meglio un modello MoE da 120B o un 70B denso?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.