Fine-tuning in locale su GB10: misurazioni e metodologia
Su una GIGABYTE AI TOP ATOM (chip NVIDIA GB10, 128 GB), un piccolo modello addestrato per un compito preciso può superare un modello molto grande su quel compito. In 85 minuti di LoRA, Qwen3-8B estrae senza alcun errore i dati del 95% di 200 fatture fittizie mai viste, contro il 62,5% di gpt-oss 120B e il 26% senza addestramento. Anche il QLoRA con Unsloth rientra nella memoria disponibile: 41 GB per un 70B, 64 GB per gpt-oss 120B. L'addestramento è costato 1,5 centesimi di elettricità lato GPU.
Il fine-tuning addestra ancora un po' un modello esistente perché riesca in un compito preciso. Con 128 GB di memoria unificata, una macchina GB10 lo fa a casa tua, senza noleggiare server né affidare i tuoi dati a un servizio online. Questa guida segue un caso completo, misurato su una AI TOP ATOM fornita gratuitamente da GIGABYTE: estrarre in JSON i dati delle fatture. Riporta anche le misurazioni del QLoRA (lo stesso metodo su un modello compresso a 4 bit) con Unsloth fino a gpt-oss 120B, e i comandi dei nostri test.
#Il caso reale: leggere fatture e produrre JSON
Il compito è comune in una piccola impresa: a partire dal testo di una fattura, di un preventivo o di una nota di credito, il modello deve restituire un JSON, cioè una scheda strutturata che un software è in grado di leggere. Questa scheda comprende 31 campi valutati: tipo di documento, numero, date, emittente, cliente, righe di prodotto, sconto, totali, IVA, acconto, IBAN. Abbiamo scelto questo compito perché la risposta si può verificare campo per campo, senza che un altro modello debba giudicarla.
I documenti sono fittizi. Un piccolo programma ha generato 12 layout, cioè 12 forme di fattura, con nomi di aziende inventati. La sua casualità è regolata da un «seed» fisso: a ogni esecuzione produce di nuovo gli stessi documenti. L'addestramento usa 2.000 documenti su 10 layout.
La valutazione usa 200 documenti mai visti: 100 sugli stessi 10 layout e 100 su 2 layout assenti dall'addestramento. Questi ultimi 100 dicono se il modello ha capito il compito o se ha solo memorizzato delle forme.
Il modello riceve il testo del documento, non un'immagine né un PDF. Ecco un estratto della risposta del modello addestrato sul primo documento di test, una nota di credito fittizia di quattro righe.
#Il metodo: LoRA, un'epoca, 85 minuti
Approfitta della nostra esperienza e di un percorso guidato per creare il tuo assistente locale e usare la tua IA ogni giorno.
- Spazio online a vita
- PDF + file
- Garanzia di rimborso di 30 giorni
La macchina è una GIGABYTE AI TOP ATOM, codice ATAGB10-9000: chip NVIDIA GB10, 128 GB di memoria unificata, SSD da 4 TB in PCIe 5.0, con DGX OS 7.5.0 (driver 580.159.03, CUDA 13.0). I software: il container PyTorch di NVIDIA (versione 26.03, con PyTorch 2.11), PEFT 0.21.2 per il LoRA, Unsloth 2026.10.1 per il QLoRA e, per il serving, il container vLLM 26.09 di NVIDIA (vLLM 0.29.0). La nostra prima guida della serie descrive in dettaglio la macchina e la velocità di 13 modelli.
LoRA (Low-Rank Adaptation) lascia intatto il modello originale e addestra piccole matrici aggiunte ai suoi layer. Il risultato è un adattatore, un piccolo file che si carica insieme al modello. Qui vengono addestrati 43,6 milioni di parametri, contro gli 8 miliardi di Qwen3-8B.
In questa guida ricorrono tre termini. Uno step di addestramento elabora un batch di 4 documenti. Un'epoca è un passaggio completo sui 2.000 documenti. La perdita misura lo scarto tra la risposta scritta dal modello e la risposta attesa: più è bassa, meglio è.
- Modello
- Qwen3-8B in bf16, un formato numerico a 16 bit, senza compressione.
- LoRA
- Rango 16, alpha 32 (un coefficiente di scala), dropout 0,05 (a ogni passo una piccola parte dei valori viene ignorata a caso, per limitare l'overfitting), sulle 7 proiezioni di ogni layer, cioè le sue 7 matrici di pesi: q, k, v, o, gate, up, down. Il rango determina la dimensione delle matrici aggiunte.
- Durata
- 1 epoca: 500 step da 4 documenti.
- Tasso di apprendimento
- 1e-4, ovvero 0,0001, con un warmup progressivo su 30 passi e poi un decadimento cosinusoidale.
- Lots
- Ordiniamo i 2.000 documenti per lunghezza, formiamo i batch e poi ne mescoliamo l'ordine con un seed fisso. Un batch contiene documenti di lunghezza simile: c'è meno padding inutile, quindi l'addestramento è più veloce.
- Perte
- Calcolata sulla sola risposta JSON. Il prompt e il documento sono mascherati: il modello impara a scrivere la risposta, non a ricopiare il documento.
- Lunghezza
- Fino a 2.304 token. Il documento più lungo ne conta 2.204, la media è di 1.143: nessuno viene troncato.
- Memoria
- Il gradient checkpointing è attivo: il modello ricalcola alcuni risultati invece di tenerli tutti in memoria.
Queste impostazioni sono state fissate da un'integrazione al nostro protocollo, datata 7 ottobre 2026, prima di qualsiasi valutazione sui 200 documenti di test. Il protocollo è stato congelato prima della prima misurazione; il metodo, l'elenco datato delle integrazioni e i dati delle nostre tabelle sono pubblicati sulla nostra pagina del metodo. In questa guida le memorie sono espresse in GB, come le mostra Linux: 1 GB = 1.024 MB.
Tutto avviene nel container PyTorch di NVIDIA (versione 26.03). Al suo interno, un ambiente Python riceve le librerie transformers e PEFT. I percorsi qui sotto sono semplificati; le opzioni sono quelle dei nostri test.
#I risultati: 95% di documenti perfetti
Il punteggio confronta, campo per campo, il valore scritto dal modello con il valore atteso, dopo la normalizzazione. Un documento è «perfetto» quando tutti i suoi campi sono esatti. I tre modelli ricevono le stesse istruzioni, a temperatura 0 (l'impostazione che rende le risposte più stabili), tramite vLLM 26.09, 16 documenti alla volta. Per Qwen3-8B, la riflessione è disattivata. Per gpt-oss 120B, lo sforzo di ragionamento è impostato su «basso».
| Modello | Campi esatti | Documenti perfetti | Perfetti, layout noti | Perfetti, layout nuovi | Durata per 200 documenti |
|---|---|---|---|---|---|
| Qwen3-8B senza addestramento | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| gpt-oss 120B senza addestramento | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 min) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
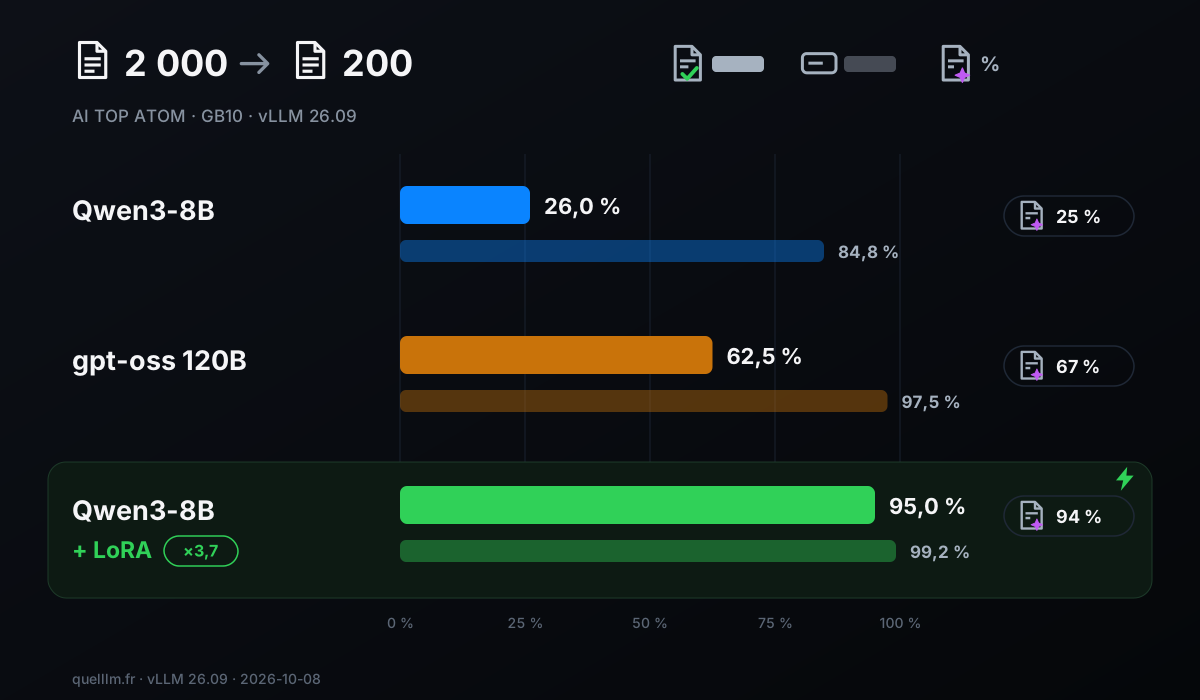
Il modello addestrato ottiene il 95,0% di documenti perfetti, contro il 26,0% dello stesso modello senza addestramento: 69 punti in più, ovvero 3,7 volte più documenti senza errori. Supera gpt-oss 120B (62,5%), un modello da 117 miliardi di parametri. È anche il più veloce: 524 secondi per i 200 documenti, contro 991 secondi per gpt-oss 120B e 686 secondi per Qwen3-8B senza addestramento. Anche le sue risposte sono più brevi: 98.847 token scritti, contro 160.702 per gpt-oss 120B.
Sui 100 documenti con layout mai visti, il modello addestrato mantiene il 94% di documenti perfetti e il 98,5% di campi esatti, contro il 96% e il 99,9% sui layout noti. Il divario è di 2 punti sui documenti perfetti (96% contro 94%): l'adattatore non si limita alle forme viste durante l'addestramento.
Il dettaglio per campo mostra che cosa ha corretto l'addestramento. Tutti i 31 campi sono esatti in almeno il 97,5% dei documenti, e 18 di essi nel 100% dei documenti. Senza addestramento, 10 campi sono esatti tra il 49,5% e il 61,5% delle volte: gli importi (sconto, totali, IVA, acconto, netto a pagare) e le righe (quantità, prezzo unitario, aliquota IVA, importo). Dopo l'addestramento, questi 10 campi sono esatti dal 98% al 100%.
I tre modelli restituiscono un JSON valido nel 100% dei casi e trovano il numero corretto di righe nel 100% dei documenti. La differenza si gioca quindi sul valore dei campi, non sulla forma della risposta.
#Quanto costa: tempo, memoria, elettricità
| Misurazione | Valore |
|---|---|
| Durata dell'addestramento | 5.090 s, ossia 85 min (10,2 s per step) |
| Picco di memoria GPU rilevato da PyTorch | 33,3 GB |
| Potenza della GPU, media e di picco | 53,0 W e 62,7 W |
| Temperatura della GPU, media e massima | 65 °C e 77 °C |
| Throttling segnalato dalla GPU | nessuno sulle 5.206 rilevazioni |
| Energia della GPU per l'addestramento (87 minuti di rilevazione, caricamento incluso) | 76,7 Wh |
| Costo alla tariffa EDF Tarif Bleu Base (20,01 centesimi per kWh IVA inclusa) | 1,5 centesimi |
| Energia della GPU per leggere i 200 documenti di test con il modello addestrato | circa 6 Wh |
Queste cifre riguardano solo la GPU, così come le riporta il chip. Secondo NVIDIA, la potenza mostrata da nvidia-smi è quella della sola GPU. Processore, memoria, SSD e alimentatore non sono conteggiati. La tariffa è quella dell'opzione Base di EDF per 6 kVA, nella griglia applicabile al 1 agosto 2026; l'abbonamento non è conteggiato.
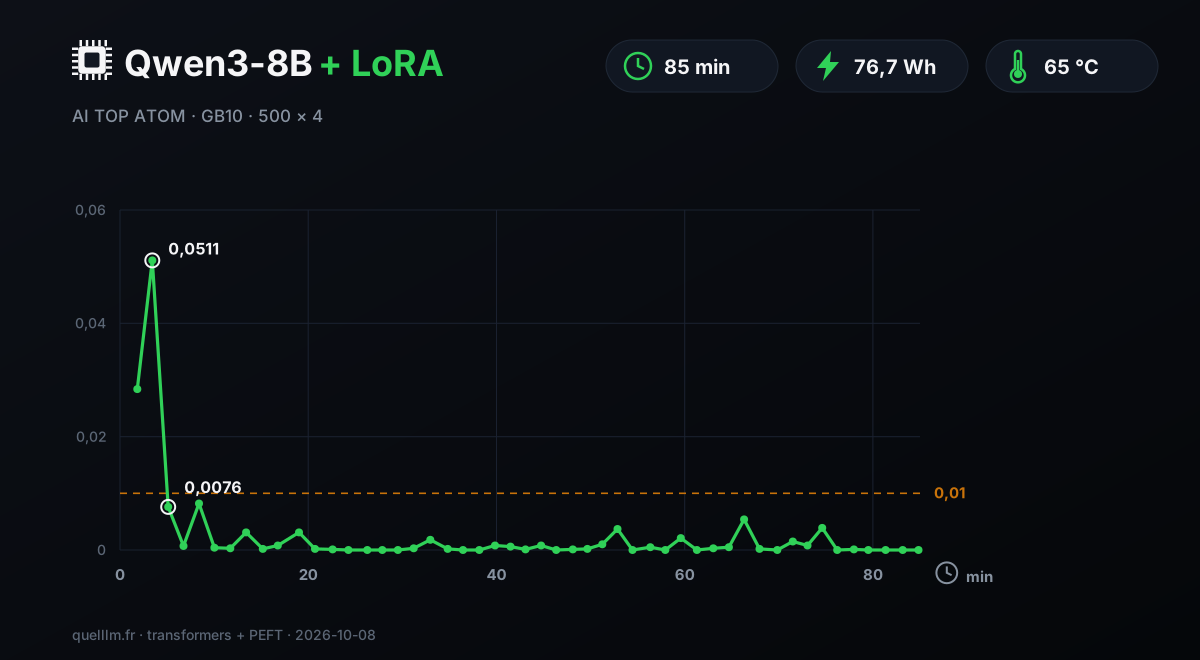
Ogni punto della curva proviene da un solo batch di 4 documenti: i valori variano quindi da una rilevazione all'altra. La loss scende sotto 0,01 già allo step 30, dopo 5 minuti di addestramento, e nessuna rilevazione successiva supera 0,0082. Una sola epoca è bastata per raggiungere il 95% di documenti perfetti in questo caso.
#QLoRA con Unsloth: un 70B e gpt-oss 120B sulla stessa macchina
Il QLoRA comprime i pesi del modello a 4 bit, riducendo notevolmente il suo ingombro in memoria, poi addestra un adattatore LoRA sopra di esso. È la strada per specializzare un modello di grandi dimensioni senza cambiare macchina. Abbiamo usato Unsloth, uno strumento libero che, secondo chi lo sviluppa, alleggerisce e accelera il fine-tuning.
NVIDIA pubblica una guida ufficiale per Unsloth su DGX Spark, in un container PyTorch di NVIDIA (versione 25.11), e offre anche un ambiente ufficiale di fine-tuning PyTorch per modelli da 1 a 70 miliardi di parametri. Unsloth dichiara circa 68 GB di memoria per un QLoRA a 4 bit di gpt-oss 120B; la nostra misurazione indica un picco di 64,4 GB, dello stesso ordine di grandezza.
Abbiamo misurato velocità e memoria su due modelli: Llama 3.3 70B e gpt-oss 120B, entrambi nel formato a 4 bit pubblicato da Unsloth. Ogni prova comprende 40 step, e i primi 10, che servono all'avvio, non sono conteggiati nella media.
Le sequenze sono di 1.024 token, con un batch di 1 e un LoRA di rango 16. Questi step, eseguiti sul testo di riferimento del nostro protocollo, misurano throughput e memoria; non producono un modello utile.
| Modello | Chargement | Memoria del modello | Picco di memoria GPU | Secondi per step | Token al secondo | Parametri addestrati |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (QLoRA a 4 bit) | 247 s | 37,6 GB | 41,3 GB | 9,39 | 109 | 207 milioni (7 proiezioni) |
| gpt-oss 120B (QLoRA a 4 bit) | 397 s | 58,5 GB | 64,4 GB | 6,35 | 161 | 11,9 milioni (4 proiezioni di attention) |
| Qwen3-8B (LoRA bf16) | — | — | 63,4 GB | 5,42 | 756 | 43,6 milioni (7 proiezioni) |
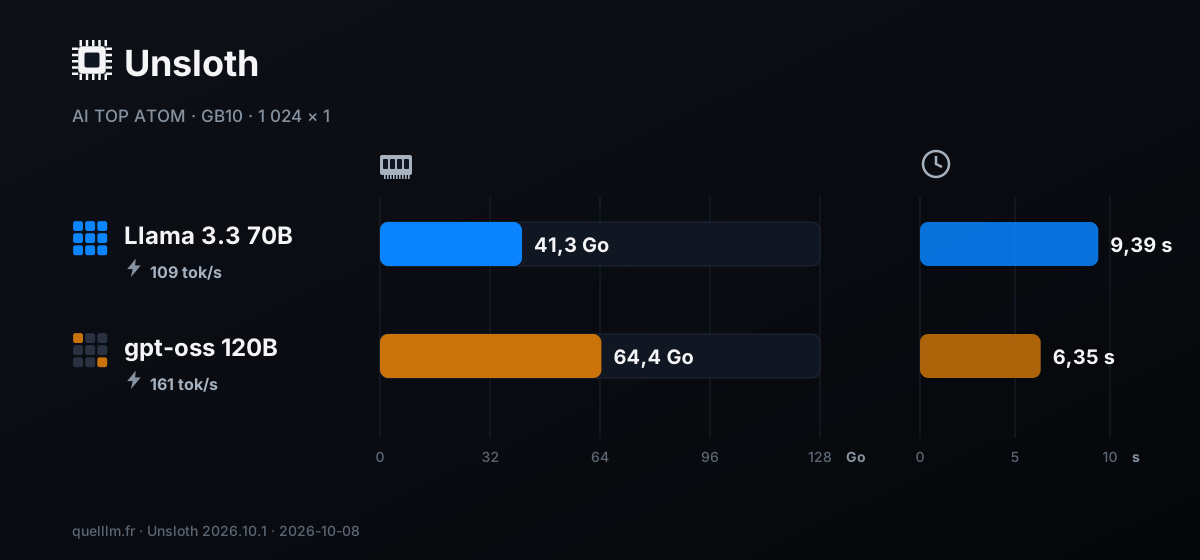
Il 70B si addestra con un picco di 41,3 GB, circa un terzo dei 121,7 GB visti dal sistema; gpt-oss 120B ne richiede 64,4 GB. In entrambi i casi resta spazio per altri servizi. Da notare: gpt-oss 120B avanza più velocemente per step rispetto al 70B (6,35 s contro 9,39 s), pur essendo più grande.
È un modello MoE, un «mix di esperti»: a ogni token usa solo 5,1 dei suoi 117 miliardi di parametri. Qui addestriamo solo le 4 matrici dell'attention (q, k, v, o), ovvero 11,9 milioni di parametri. Il 70B riceve invece un LoRA sulle sue 7 proiezioni, ovvero 207 milioni di parametri addestrati.
Per pianificare, ecco un calcolo basato sulle nostre misurazioni. 1 000 passi da 1 024 token, ossia circa un milione di token, richiederebbero 2 h 36 min con il 70B e 1 h 46 min con gpt-oss 120B. Verifica queste durate sul tuo dataset. Il QLoRA del 70B ha occupato la GPU per 10,8 minuti, compreso il caricamento del modello, per 8,9 Wh lato GPU.
Unsloth 2026.10.1 è installato nello stesso ambiente Python visto sopra, nello stesso container PyTorch. Per l'installazione passo passo, segui la guida ufficiale di NVIDIA e la documentazione di Unsloth, con i link a fine pagina.
#Servire il modello addestrato con vLLM
vLLM è un server open source, progettato per rispondere a più persone contemporaneamente; lo usiamo nel container fornito da NVIDIA. Carica il modello originale e poi vi aggiunge l'adattatore. L'API espone quindi due nomi: Qwen3-8B, senza adattatore, e factures, con l'adattatore. Abbiamo valutato entrambi sullo stesso server, il che rende equo il confronto.
Con 16 documenti inviati contemporaneamente, le 200 fatture vengono elaborate in 524 secondi. A questo ritmo, 1.000 fatture richiedono circa 44 minuti: è un calcolo basato sulla nostra misurazione. La porta è associata all'indirizzo locale 127.0.0.1. Per aprire il servizio alla tua rete, aggiungi una chiave API; la guida su vLLM in produzione descrive in dettaglio questo passaggio.
#Rifai questo caso da te in cinque passaggi
- 01Prepara gli esempiRaccogli delle coppie: il testo di un documento e la risposta JSON attesa. Scrivi un solo prompt, lo stesso per l'addestramento e per la valutazione. Noi abbiamo usato 2.000 esempi; non abbiamo misurato una soglia minima.
- 02Tieni da parte un set di testMetti da parte dei documenti senza mai mostrarli al modello. Aggiungi anche qualche layout assente dall'addestramento, per capire se il modello generalizza.
- 03Addestra per un'epocaOrdina gli esempi per lunghezza, forma i batch, calcola la loss sulla sola risposta e tieni d'occhio la curva di loss.
- 04Valuta prima e dopoValuta il modello originale e quello addestrato con lo stesso prompt, campo per campo. Valuta anche un grande modello senza addestramento: è il confronto più utile.
- 05Servi il modello con vLLMCarica l'adattatore con l'opzione enable-lora e collega il tuo software all'API.
#Fine-tuning, RAG o un prompt migliore: cosa scegliere?
Inizia dal prompt: è gratis e immediato. Se il modello deve ritrovare dei fatti nei tuoi documenti, è più adatto un RAG: un assistente che prima cerca nei tuoi file e poi risponde.
Il fine-tuning è lo strumento giusto quando l'attività si ripete, il formato di output deve restare stabile e hai a disposizione degli esempi. La lettura delle fatture soddisfa queste tre condizioni. I due approcci si possono combinare sulla stessa macchina; un'altra guida della serie mostra un assistente RAG completo.
#I limiti delle nostre misurazioni
- Documenti fittizi
- Le nostre fatture sono generate da uno script, con 12 layout. Documenti reali, scansionati o fotografati, richiedono prima una lettura del testo (OCR) e possono dare risultati diversi.
- Un solo addestramento
- Abbiamo addestrato un solo adattatore e valutato ogni modello una volta, a temperatura 0. Non abbiamo misurato la variazione da un addestramento all'altro né fatto confronti con un addestramento più lungo.
- gpt-oss 120B
- Viene valutato con uno sforzo di ragionamento basso. Un'altra impostazione può cambiarne il punteggio.
- QLoRA
- Le misurazioni QLoRA riguardano velocità e memoria, su 40 step. Non abbiamo valutato la qualità di modelli 70B o 120B addestrati.
- Energia
- Riguarda solo la GPU.
- Fuori ambito
- Non abbiamo misurato l'addestramento di tutti i parametri di un modello, né l'uso di più macchine collegate.
Aggiornamenti e correzioni: questa pagina verrà rivista se una nuova versione di Unsloth, vLLM o DGX OS cambierà questi risultati; ogni correzione sarà datata.
#Per chi l'ATOM è la scelta giusta
- Una PMI o uno studio professionale che vuole specializzare un piccolo modello sui propri documenti
- 85 minuti e 1,5 centesimi di elettricità lato GPU per passare dal 26% al 95% di fatture perfette sul nostro set di fatture fittizie, senza inviare un solo documento a terzi.
- Uno sviluppatore o un team di dati che crea prototipi
- Qwen3-8B in LoRA, un 70B o gpt-oss 120B in QLoRA: tutti e tre entrano nella stessa macchina, con un picco di memoria GPU da 33 a 64 GB.
- Un team che vuole addestrare, valutare e servire i modelli nello stesso posto
- La stessa macchina ha addestrato l'adattatore, valutato tre modelli e servito le risposte con vLLM.
- Un ufficio senza sala server
- Un case da un litro (150 × 150 × 50,5 mm, 1,2 kg) alimentato da un adattatore USB-C da 240 W.
Distinguiamo la piattaforma dal produttore. Il chip NVIDIA GB10, i suoi 128 GB di memoria unificata a 273 GB/s, CUDA e DGX OS 7.5.0 determinano gran parte delle velocità di addestramento. In inferenza, le nostre misurazioni si discostano al massimo del 4,3% da quelle pubblicate per il DGX Spark; gli addestramenti di questa guida sono stati eseguiti sull'AI TOP ATOM.
GIGABYTE fornisce lo chassis e il suo raffreddamento a due ventole. Durante gli 87 minuti di rilevazione dell'addestramento, con una media di 53 W lato GPU, la temperatura è rimasta in media a 65 °C e al massimo a 77 °C, senza alcun throttling segnalato.
Prezzi rilevati l'8 ottobre 2026 per l'ATAGB10-9001 (128 GB, SSD da 4 TB PCIe 4.0): 6.346,27 € IVA inclusa sul negozio ufficiale AORUS, dove era esaurita; era disponibile su Amazon.fr. Abbiamo misurato il modello ATAGB10-9000, il cui SSD è PCIe 5.0. I prezzi delle GB10 cambiano ogni settimana: verificali prima di acquistare.
#FAQ
Quanto tempo serve per il fine-tuning di un modello da 8 miliardi di parametri su una GB10?+
Si può fare il fine-tuning di un modello 70B o gpt-oss 120B con 128 GB?+
Un piccolo modello addestrato può davvero superare un grande modello?+
Quanto costa l'elettricità di un fine-tuning?+
Come si usa l'adattatore una volta terminato l'addestramento?+
Serve la versione da 128 GB dell'ATOM per fare il fine-tuning?+
Un feedback, un errore, una precisazione? Facci sapere, così la guida migliora per tutti.